
컨테이너 클래스
소개
QStringQt 라이브러리는 범용 템플릿 기반 컨테이너 클래스 세트를 제공합니다. 이러한 클래스는 지정된 유형의 항목을 저장하는 데 사용할 수 있습니다. 예를 들어, 크기 조정이 가능한 ` QString` 배열이 필요한 경우 ` QList<XML-ph-0002@deepl.internal>`를 사용하십시오.
이러한 컨테이너 클래스는 STL 컨테이너보다 더 가볍고, 안전하며, 사용하기 쉽도록 설계되었습니다. STL에 익숙하지 않거나 “Qt 방식”을 선호하는 경우, STL 클래스 대신 이 클래스를 사용할 수 있습니다.
이 컨테이너 클래스들은 암시적으로 공유되며, 재진입이 가능하고, 속도, 낮은 메모리 소비, 최소한의 인라인 코드 확장을 위해 최적화되어 있어 실행 파일 크기를 줄여줍니다. 또한, 이에 액세스하는 모든 스레드가 읽기 전용 컨테이너로 사용하는 상황에서는 스레드 안전성을 보장합니다.
이 컨테이너들은 탐색을 위한 이터레이터를 제공합니다. STL 스타일의 이터레이터가 가장 효율적이며, Qt XML 및 STL의 generic algorithms 와 함께 사용할 수 있습니다. Java 스타일의 이터레이터는 하위 호환성을 위해 제공됩니다.
참고: Qt 5.14부터 대부분의 컨테이너 클래스에서 범위 생성자(range constructors)를 사용할 수 있습니다. ` QMultiMap `는 주목할 만한 예외입니다. Qt 5에서 사용이 권장되지 않는 다양한 `from` 및 `to` 메서드를 대체하기 위해 범위 생성자의 사용을 권장합니다. 예를 들어:
QList<int> list = {1, 2, 3, 4, 4, 5};
QSet<int> set(list.cbegin(), list.cend());
/*
    Will generate a QSet containing 1, 2, 3, 4, 5.
*/
컨테이너 클래스
Qt는 다음과 같은 순차적 컨테이너를 제공합니다: QList, QStack, QQueue. 대부분의 애플리케이션에서는 QList 을 사용하는 것이 가장 좋습니다. 이 클래스는 매우 빠른 추가(append) 기능을 제공합니다. 링크드 리스트가 반드시 필요한 경우에는 std::list를 사용하십시오. QStack 및 QQueue 는 LIFO 및 FIFO 세미오틱스를 제공하는 편의 클래스입니다.
Qt는 또한 다음과 같은 연관 컨테이너를 제공합니다: QMap, QMultiMap, QHash, QMultiHash, QSet. "Multi" 컨테이너는 단일 키에 여러 값을 편리하게 연결할 수 있도록 지원합니다. "Hash" 컨테이너는 정렬된 집합에 대한 이진 검색 대신 해시 함수를 사용하여 더 빠른 검색 속도를 제공합니다.
특수한 경우로, QCache 및 QContiguousCache 클래스는 제한된 캐시 저장 공간 내에서 객체에 대한 효율적인 해시 조회 기능을 제공합니다.
| 클래스 | 요약 |
|---|---|
| QList<T> | 이 클래스는 단연 가장 널리 사용되는 컨테이너 클래스입니다. 이 클래스는 인덱스를 통해 액세스할 수 있는 특정 유형(T)의 값 목록을 저장합니다. 내부적으로는 메모리 내 인접한 위치에 특정 유형의 값들로 구성된 배열을 저장합니다. 목록의 맨 앞이나 중간에 요소를 삽입하는 작업은 메모리에서 많은 수의 항목을 한 칸씩 이동시켜야 할 수 있기 때문에 상당히 느릴 수 있습니다. |
| QVarLengthArray<T, Prealloc> | 이 클래스는 저수준 가변 길이 배열을 제공합니다. 속도가 특히 중요한 경우 QList 대신 사용할 수 있습니다. |
| QStack<T> | 이는 “후입선출(LIFO)” 세미언틱을 제공하는 ` QList `의 편의 하위 클래스입니다. 이 클래스는 ` QList`에 이미 존재하는 함수들에 다음 함수들을 추가합니다: ` push()`, ` pop()`, ` top()`. |
| QQueue<T> | 이 클래스는 “선입선출(FIFO)” 세미언틱을 제공하는 QList 의 편의 서브클래스입니다. 이 클래스는 QList 에 이미 존재하는 함수들에 다음 함수들을 추가합니다: enqueue(), dequeue(), head(). |
| QSet<T> | 이는 빠른 조회 기능을 갖춘 단일 값 수학적 집합을 제공합니다. |
| QMap<Key, T> | 이는 Key 유형의 키를 T 유형의 값에 매핑하는 사전(연관 배열)을 제공합니다. 일반적으로 각 키는 하나의 값과 연관됩니다. QMap 는 데이터를 Key 순서대로 저장합니다. 순서가 중요하지 않은 경우 QHash 를 사용하는 것이 더 빠릅니다. |
| QMultiMap<Key, T> | QMap 와 유사한 사전(연관 배열)을 제공하지만, 동일한 키를 여러 개 삽입할 수 있다는 점이 다릅니다. |
| QHash<Key, T> | 이 구조는 QMap 과 거의 동일한 API를 갖지만, 조회 속도가 훨씬 빠릅니다. QHash 는 데이터를 임의의 순서로 저장합니다. |
| QMultiHash<Key, T> | QHash 와 같은 해시 테이블 기반 딕셔너리를 제공하지만, 동일한 값을 가지는 키를 여러 개 삽입할 수 있다는 점이 다릅니다. |
컨테이너는 중첩될 수 있습니다. 예를 들어, 키 유형이 QString 이고 값 유형이 QList<int>인 QMap<QString, QList<int>>를 사용하는 것이 전혀 문제없습니다.
컨테이너들은 컨테이너와 동일한 이름을 가진 개별 헤더 파일(예: <QList>)에 정의되어 있습니다. 편의상, 이 컨테이너들은 <QtContainerFwd> 에서 사전 선언되어 있습니다.
다양한 컨테이너에 저장되는 값은 할당 가능한 모든 데이터 유형일 수 있습니다. 이를 충족하려면 유형은 복사 생성자와 할당 연산자를 제공해야 합니다. 일부 연산의 경우 기본 생성자도 필요합니다. 이는 int 및 double 와 같은 기본 유형, 포인터 유형, QString, QDate, QTime 와 같은 Qt 데이터 유형을 포함하여 컨테이너에 저장하고자 할 가능성이 높은 대부분의 데이터 유형을 다루지만, QObject 이나 QObject 의 하위 클래스(QWidget, QDialog, QTimer 등)는 다루지 않습니다. QList<QWidget>를 인스턴스화하려고 시도하면, 컴파일러는 QWidget 의 복사 생성자 및 할당 연산자가 비활성화되었다는 오류 메시지를 표시합니다. 이러한 종류의 객체를 컨테이너에 저장하려면, 포인터 형태로 저장해야 합니다. 예를 들어, QList<QWidget *>와 같이 저장하면 됩니다.
다음은 할당 가능한 데이터 유형의 요구 사항을 충족하는 사용자 정의 데이터 유형의 예입니다:
class Employee
{
public:
    Employee() {}
    Employee(const Employee &other);

    Employee &operator=(const Employee &other);

private:
    QString myName;
    QDate myDateOfBirth;
};
복사 생성자나 할당 연산자를 제공하지 않으면, C++은 멤버별로 복사하는 기본 구현을 제공합니다. 위의 예제에서는 그것만으로도 충분했을 것입니다. 또한, 생성자를 전혀 제공하지 않으면 C++은 기본 생성자를 사용하여 멤버를 초기화하는 기본 생성자를 제공합니다. 명시적인 생성자나 할당 연산자를 제공하지 않더라도, 다음 데이터 유형은 컨테이너에 저장될 수 있습니다:
일부 컨테이너는 저장할 수 있는 데이터 유형에 대해 추가적인 요구 사항을 갖습니다. 예를 들어, ` QMap<Key, T>`의 `Key` 유형은 ` operator<()`를 제공해야 합니다. 이러한 특별한 요구 사항은 클래스의 상세 설명에 명시되어 있습니다. 경우에 따라 특정 함수에 특별한 요구 사항이 있을 수 있으며, 이는 함수별로 설명됩니다. 요구 사항이 충족되지 않으면 컴파일러는 항상 오류를 발생시킵니다.
Qt의 컨테이너는 QDataStream 를 사용하여 데이터를 쉽게 읽고 쓸 수 있도록 operator<<()와 operator>>()를 제공합니다. 즉, 컨테이너에 저장된 데이터 유형도 operator<<()와 operator>>()를 지원해야 합니다. 이러한 지원을 구현하는 것은 간단합니다. 위의 Movie 구조체에 대해 다음과 같이 구현할 수 있습니다:
QDataStream &operator<<(QDataStream &out, const Movie &movie)
{
    out << (quint32)movie.id << movie.title
        << movie.releaseDate;
    return out;
}

QDataStream &operator>>(QDataStream &in, Movie &movie)
{
    quint32 id;
    QDate date;

    in >> id >> movie.title >> date;
    movie.id = (int)id;
    movie.releaseDate = date;
    return in;
}
특정 컨테이너 클래스 함수의 문서에서는 기본 생성된 값을 언급합니다. 예를 들어, ` QList `은 항목을 기본 생성된 값으로 자동으로 초기화하며, ` QMap::value()`은 지정된 키가 맵에 없을 경우 기본 생성된 값을 반환합니다. 대부분의 값 형식의 경우, 이는 단순히 기본 생성자를 사용하여 값이 생성됨을 의미합니다(예: QString 의 경우 빈 문자열). 그러나 int 및 double 과 같은 기본형(primitive type)과 포인터 형식의 경우, C++ 언어는 어떠한 초기화 방식도 명시하지 않습니다. 이러한 경우, Qt의 컨테이너는 값을 자동으로 0으로 초기화합니다.
컨테이너를 순회하기
범위 기반 for
컨테이너의 경우 범위 기반 ` for `을 사용하는 것이 바람직합니다:
const가 아닌 컨텍스트에서 Qt 컨테이너를 사용할 경우, 암시적 공유(implicit sharing) 로 인해 컨테이너가 의도하지 않게 분리될 수 있다는 점에 유의하십시오. 이를 방지하려면 ` std::as_const()`을 사용하십시오:
연관 컨테이너의 경우, 이 코드는 값들을 순차적으로 순회합니다.
인덱스 기반
메모리 내에 항목을 연속적으로 저장하는 순차적 컨테이너(예: QList)의 경우, 인덱스 기반 반복을 사용할 수 있습니다:
QList<QString> list = {"A", "B", "C", "D"};
for (qsizetype i = 0; i < list.size(); ++i) {
    const auto &item = list.at(i);
    //...
}
이테레이터 클래스
이터레이터는 컨테이너 내의 항목에 접근할 수 있는 통일된 수단을 제공합니다. Qt의 컨테이너 클래스는 STL 스타일 이터레이터와 Java 스타일 이터레이터, 두 가지 유형의 이터레이터를 제공합니다. 두 유형의 이터레이터 모두, 컨테이너 내의 데이터가 수정되거나, non-const 멤버 함수 호출로 인해 암시적으로 공유되던 복사본에서 분리될 경우 무효화됩니다.
STL 스타일 이터레이터
STL 스타일 이터레이터는 Qt 2.0 출시 이후부터 사용할 수 있게 되었습니다. 이들은 Qt와 STL의 ` generic algorithms `과 호환되며, 속도 최적화가 되어 있습니다.
각 컨테이너 클래스마다 두 가지 STL 스타일 이터레이터 유형이 있습니다. 하나는 읽기 전용 액세스를 제공하고, 다른 하나는 읽기-쓰기 액세스를 제공합니다. 읽기 전용 이터레이터는 읽기-쓰기 이터레이터보다 속도가 빠르므로 가능한 한 읽기 전용 이터레이터를 사용해야 합니다.
| 컨테이너 | 읽기 전용 반복자 | 읽기-쓰기 이터레이터 |
|---|---|---|
| QList<T>, QStack<T>, QQueue<T> | QList<T>::const_iterator | QList<T>::iterator |
| QSet<T> | QSet<T>::const_iterator | QSet<T>::iterator |
| QMap<Key, T>, QMultiMap<Key, T> | QMap<Key, T>::const_iterator | QMap<Key, T>::iterator |
| QHash<Key, T>, QMultiHash<Key, T> | QHash<Key, T>::const_iterator | QHash<Key, T>::iterator |
STL 이터레이터의 API는 배열 내의 포인터를 모델로 합니다. 예를 들어, ` ++ ` 연산자는 이터레이터를 다음 항목으로 이동시키고, ` * ` 연산자는 이터레이터가 가리키는 항목을 반환합니다. 실제로, 항목을 인접한 메모리 위치에 저장하는 ` QList `와 ` QStack`의 경우, ` iterator ` 유형은 단순히 ` T *`에 대한 `typedef`이며, ` const_iterator ` 유형은 단순히 ` const T *`에 대한 `typedef`입니다.
이 논의에서는 QList 와 QMap 에 집중할 것입니다. QSet 의 이터레이터 유형은 QList 의 이터레이터와 정확히 동일한 인터페이스를 가지며, 마찬가지로 QHash 의 이터레이터 유형은 QMap 의 이터레이터와 동일한 인터페이스를 가집니다.
다음은 QList<QString>의 모든 요소를 순서대로 순회하며 소문자로 변환하는 일반적인 루프 예시입니다:
QList<QString> list = {"A", "B", "C", "D"};

for (auto i = list.begin(), end = list.end(); i != end; ++i)
    *i = (*i).toLower();
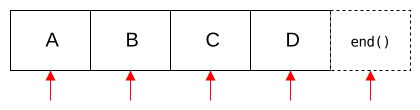
STL 스타일의 이터레이터는 항목을 직접 가리킵니다. 컨테이너의 begin() 함수는 컨테이너의 첫 번째 항목을 가리키는 이터레이터를 반환합니다. 컨테이너의 ` end()` 함수는 컨테이너의 마지막 항목 바로 다음 위치에 있는 가상의 항목을 가리키는 이터레이터를 반환합니다. ` end()`는 유효하지 않은 위치를 나타내며, 절대로 간접 참조해서는 안 됩니다. 이 함수는 일반적으로 루프의 중단 조건에서 사용됩니다. 리스트가 비어 있다면, ` begin()`는 ` end()`과 같으므로 루프가 절대 실행되지 않습니다.
아래 다이어그램은 네 개의 항목을 포함하는 리스트에 대해 유효한 이터레이터 위치를 빨간색 화살표로 표시하고 있습니다:
STL 스타일의 이터레이터를 사용하여 역방향으로 반복하려면 역 이터레이터를 사용합니다:
QList<QString> list = {"A", "B", "C", "D"};

for (auto i = list.rbegin(), rend = list.rend(); i != rend; ++i)
    *i = i->toLower();
지금까지 살펴본 코드 예제에서는 단항 연산자 ` * `를 사용하여 특정 이터레이터 위치에 저장된 항목( QString 형)을 가져온 다음, 해당 항목에 대해 ` QString::toLower()`를 호출했습니다.
읽기 전용 액세스의 경우 const_iterator, cbegin() 및 cend()를 사용할 수 있습니다. 예를 들어:
for (auto i = list.cbegin(), end = list.cend(); i != end;++i)
    qDebug() << *i;
다음 표는 STL 스타일 이터레이터의 API를 요약한 것입니다:
| 표현식 | 동작 |
|---|---|
*i | 현재 항목을 반환합니다 |
++i | 이테레이터를 다음 항목으로 이동시킵니다 |
i += n | 이테레이터를 n 개 항목만큼 앞으로 이동시킵니다 |
--i | 이테레이터를 한 항목 뒤로 이동합니다 |
i -= n | 이테레이터를 n 개 항목만큼 뒤로 이동시킵니다 |
i - j | i 와 j |
++ 및 -- 연산자는 접두사(++i, --i) 및 접미사(i++, i--) 연산자 모두로 사용할 수 있습니다. 접두사 버전은 반복자를 수정하고 수정된 반복자에 대한 참조를 반환하는 반면, 접미사 버전은 반복자를 수정하기 전에 복사본을 생성한 후 해당 복사본을 반환합니다. 반환 값이 무시되는 표현식에서는 접두사 연산자(++i, --i)를 사용하는 것이 좋습니다. 이 연산자들이 약간 더 빠르기 때문입니다.
const가 아닌 이터레이터 유형의 경우, 단항 * 연산자의 반환 값을 할당 연산자의 왼쪽에 사용할 수 있습니다.
QMap 및 QHash 의 경우, * 연산자는 항목의 값 성분을 반환합니다. 키를 가져오려면 이터레이터에서 key()를 호출하십시오. 대칭성을 위해 이터레이터 유형은 값을 가져오기 위한 value() 함수도 제공합니다. 예를 들어, QMap 에 있는 모든 항목을 콘솔에 출력하는 방법은 다음과 같습니다:
QMap<int, int> map;
//...
for (auto i = map.cbegin(), end = map.cend(); i != end;++i)
    qDebug() << i.key() << ':' << i.value();
암시적 공유 덕분에 함수가 컨테이너를 값으로 반환하는 데 드는 비용은 매우 적습니다. Qt API에는 값으로 QList 또는 QStringList 를 반환하는 수십 개의 함수가 포함되어 있습니다(예: QSplitter::sizes()). STL 이터레이터를 사용하여 이러한 컨테이너를 반복 처리하려면 항상 컨테이너의 복사본을 생성한 후, 그 복사본을 반복 처리해야 합니다. 예를 들어:
// RIGHT
const QList<int> sizes = splitter->sizes();
for (auto i = sizes.begin(), end = sizes.end(); i != end; ++i)
    {/*...*/}

// WRONG
for (auto i = splitter->sizes().begin();
        i != splitter->sizes().end(); ++i)
    {/*...*/}
컨테이너에 대한 const 또는 non-const 참조를 반환하는 함수의 경우에는 이러한 문제가 발생하지 않습니다.
암시적 공유 이터레이터 문제
암시적 공유는 STL 스타일의 이터레이터에 또 다른 영향을 미칩니다. 즉, 해당 컨테이너에서 이터레이터가 활성화된 상태에서는 컨테이너를 복사하지 않도록 주의해야 합니다. 이터레이터는 내부 구조를 가리키므로, 컨테이너를 복사할 때는 이터레이터 처리에 각별히 주의해야 합니다. 예:
QList<int> a, b;
a.resize(100000); // make a big list filled with 0.

QList<int>::iterator i = a.begin();
// WRONG way of using the iterator i:
b = a;
/*
    Now we should be careful with iterator i since it will point to shared data
    If we do *i = 4 then we would change the shared instance (both vectors)
    The behavior differs from STL containers. Avoid doing such things in Qt.
*/

a[0] = 5;
/*
    Container a is now detached from the shared data,
    and even though i was an iterator from the container a, it now works as an iterator in b.
    Here the situation is that (*i) == 0.
*/

b.clear(); // Now the iterator i is completely invalid.

int j = *i; // Undefined behavior!
/*
    The data from b (which i pointed to) is gone.
    This would be well-defined with STL containers (and (*i) == 5),
    but with QList this is likely to crash.
*/
위의 예제는 ` QList`의 문제만 보여주고 있지만, 이 문제는 암시적 공유가 적용되는 모든 Qt 컨테이너에서 발생합니다.
자바 스타일 이터레이터
Java 스타일 반복자는 Java의 반복자 클래스를 모델로 합니다. 새로운 코드를 작성할 때는 STL 스타일 반복자를 우선적으로 사용해야 합니다.
Qt 컨테이너와 std 컨테이너의 비교
| Qt 컨테이너 | 가장 유사한 std 컨테이너 |
|---|---|
| QList<T> | std::vector<T>와 유사함 QList QVector 는 Qt 6에서 통합되었습니다. 둘 다 의 데이터 모델을 사용합니다. 는 이제 의 별칭입니다. QVector QVector QList 이는 QList 가 링크드 리스트로 구현되지 않았음을 의미합니다. 따라서 삽입, 삭제, 후행 추가 또는 선행 추가를 상수 시간 내에 수행해야 하는 경우 |
| QVarLengthArray<T, Prealloc> | std::array<T>와 std::vector<T>가 혼합된 형태와 유사합니다. 성능상의 이유로, QVarLengthArray 는 크기가 조정되지 않는 한 스택에 상주합니다. 크기를 조정하면 자동으로 힙을 사용하게 됩니다. |
| QStack<T> | std::stack<T>와 유사하며, QList 을 상속받습니다. |
| QQueue<T> | std::queue<T>와 유사하며, QList 를 상속받습니다. |
| QSet<T> | std::unordered_set<T>와 유사합니다. 내부적으로 QSet 는 QHash 로 구현됩니다. |
| QMap<Key, T> | std::map<Key, T>와 유사합니다. |
| QMultiMap<Key, T> | std::multimap<Key, T>와 유사합니다. |
| QHash<Key, T> | std::unordered_map<Key, T>와 가장 유사합니다. |
| QMultiHash<Key, T> | std::unordered_multimap<Key, T>와 가장 유사합니다. |
Qt 컨테이너와 std 알고리즘
#include <algorithm> 에 정의된 함수와 함께 Qt 컨테이너를 사용할 수 있습니다.
QList<int> list = {2, 3, 1};

std::sort(list.begin(), list.end());
/*
    Sort the list, now contains { 1, 2, 3 }
*/

std::reverse(list.begin(), list.end());
/*
    Reverse the list, now contains { 3, 2, 1 }
*/

int even_elements =
        std::count_if(list.begin(), list.end(), [](int element) { return (element % 2 == 0); });
/*
    Count how many elements that are even numbers, 1
*/
Qt 컨테이너 알고리즘
또한 Qt는 <QtAlgorithms> 에서 STL 스타일의 반복자를 지원하는 모든 컨테이너와 함께 사용할 수 있는 추가적인 제네릭 알고리즘을 제공합니다. 예를 들어, 컨테이너의 요소들을 하나의 값으로 결합하는 ` qJoin()`이나, 컨테이너 내의 모든 항목 또는 지정된 범위의 항목에 대해 ` operator delete `을 호출하는 ` qDeleteAll()` 등이 있습니다.
기타 컨테이너와 유사한 클래스
Qt에는 어떤 면에서 컨테이너와 유사한 다른 템플릿 클래스들이 포함되어 있습니다. 이러한 클래스는 이터레이터를 제공하지 않으며, ` foreach ` 키워드와 함께 사용할 수 없습니다.
- QCache<Key, T>는 Key 유형의 키와 연관된 특정 유형 T의 객체를 저장하기 위한 캐시를 제공합니다.
- QContiguousCache<T>는 일반적으로 연속적으로 액세스되는 데이터를 효율적으로 캐싱하는 방법을 제공합니다.
Qt의 템플릿 컨테이너와 경쟁 관계에 있는 추가적인 비템플릿 유형으로는 QBitArray, QByteArray, QString 및 QStringList 가 있습니다.
알고리즘의 복잡도
알고리즘적 복잡도는 컨테이너에 저장된 항목의 수가 늘어남에 따라 각 함수가 얼마나 빠르거나 느린지에 관한 것입니다. 예를 들어, std::list의 중간에 항목을 삽입하는 작업은 리스트에 저장된 항목의 수와 관계없이 매우 빠른 연산입니다. 반면, QList 의 중간에 항목을 삽입하는 작업은 QList 에 많은 항목이 포함되어 있는 경우, 메모리 상에서 항목의 절반을 한 칸씩 이동시켜야 하기 때문에 잠재적으로 매우 많은 비용이 들 수 있습니다.
알고리즘의 복잡도를 설명하기 위해, “빅 오(big Oh)” 표기법을 기반으로 다음과 같은 용어를 사용합니다:
- 상수 시간: O(1). 컨테이너에 항목이 몇 개 있든 상관없이 항상 동일한 시간이 소요되는 함수를 상수 시간에 실행되는 함수라고 합니다. 한 가지 예로는 QList::push_back()이 있습니다.
- 로그 시간: O(log n). 로그 시간에 실행되는 함수는 실행 시간이 컨테이너에 들어 있는 항목 수의 로그에 비례하는 함수입니다. 이진 탐색 알고리즘이 그 예입니다.
- 선형 시간: O(n). 선형 시간에 실행되는 함수는 컨테이너에 저장된 항목 수에 직접 비례하는 시간 내에 실행됩니다. 한 가지 예로는 QList::insert()이 있습니다.
- 선형-로그 시간: O(n log n). 선형-로그 시간에 실행되는 함수는 선형 시간 함수보다 점근적으로 느리지만, 2차 시간 함수보다는 빠릅니다.
- 2차 시간: O(n²). 2차 시간 함수는 컨테이너에 저장된 항목 수의 제곱에 비례하는 시간 내에 실행됩니다.
다음 표는 순차적 컨테이너 QList<T>의 알고리즘적 복잡도를 요약한 것입니다:
| 인덱스 조회 | 삽입 | 선두 삽입 | 추가 | |
|---|---|---|---|---|
| QList<T> | O(1) | O(n) | O(n) | 평균 O(1) |
표에서 "Amort."는 "평균 시간 복잡도(amortized behavior)"를 의미합니다. 예를 들어, “Amort. O(1)”은 함수를 한 번만 호출하면 O(n)의 동작을 보일 수 있지만, 여러 번(예: n번 ) 호출할 경우 평균적인 동작은 O(1)이 된다는 것을 의미합니다.
다음 표는 Qt의 연산자 컨테이너와 집합의 알고리즘 복잡도를 요약한 것입니다:
| 키 조회 | 삽입 | |||
|---|---|---|---|---|
| 평균 | 최악의 경우 | 평균 | 최악의 경우 | |
| QMap<Key, T> | O(log n) | O(log n) | O(log n) | O(log n) |
| QMultiMap<Key, T> | O(log n) | O(log n) | O(log n) | O(log n) |
| QHash<Key, T> | 평균 O(1) | O(n) | 평균 O(1) | O(n) |
| QSet<키> | 평균 시간 복잡도 O(1) | O(n) | 평균 시간 복잡도 O(1) | O(n) |
QList, QHash 및 QSet 를 사용할 경우, 항목을 추가하는 작업의 평균 시간은 O(log n)입니다. 항목을 삽입하기 전에 예상 항목 수를 인수로 전달하여 QList::reserve(), QHash::reserve() 또는 QSet::reserve()를 호출하면 이 시간을 O(1)까지 줄일 수 있습니다. 다음 섹션에서는 이 주제에 대해 더 자세히 다룹니다.
기본형 및 재배치 가능한 형식에 대한 최적화
Qt 컨테이너는 저장된 요소가 재배치 가능하거나 심지어 기본형일 경우 최적화된 코드 경로를 사용할 수 있습니다. 그러나 유형이 기본형인지 재배치 가능한지 여부는 모든 경우에 감지할 수 있는 것은 아닙니다. Q_DECLARE_TYPEINFO 매크로에 Q_PRIMITIVE_TYPE 플래그나 Q_RELOCATABLE_TYPE 플래그를 사용하여 타입을 기본형 또는 재배치 가능한 타입으로 선언할 수 있습니다. 자세한 내용과 사용 예제는 Q_DECLARE_TYPEINFO 문서를 참조하십시오.
Q_DECLARE_TYPEINFO 를 사용하지 않는 경우, Qt는 std::is_trivial_v<T> 를 사용하여 기본형을 식별하고, std::is_trivially_copyable_v<T> 와 std::is_trivially_destructible_v<T> 를 모두 사용하여 재배치 가능한 유형을 식별합니다. 성능 면에서는 다소 비효율적일 수 있지만, 이는 항상 안전한 선택입니다.
확장 전략
QList<T>, QString 및 QByteArray 는 항목을 메모리에 연속적으로 저장하는 반면, QHash<Key, T>는 해시 내 항목 수에 비례하는 크기의 해시 테이블을 유지합니다. 컨테이너 끝에 항목이 추가될 때마다 데이터를 재할당하는 것을 피하기 위해, 이러한 클래스는 일반적으로 필요한 양보다 더 많은 메모리를 할당합니다.
다음 코드를 살펴보겠습니다. 이 코드는 다른 QString 를 사용하여 QString 를 생성합니다:
QString onlyLetters(const QString &in)
{
    QString out;
    for (qsizetype j = 0; j < in.size(); ++j) {
        if (in.at(j).isLetter())
            out += in.at(j);
    }
    return out;
}
out 문자열을 한 번에 한 글자씩 추가하여 동적으로 생성합니다. QString 문자열에 15,000개의 문자를 추가한다고 가정해 봅시다. 그러면 QString 의 공간이 부족해질 때, 가능한 15,000회 중 다음 11회의 reallocation이 발생합니다: 8, 24, 56, 120, 248, 504, 1016, 2040, 4088, 8184, 16376. 최종적으로 QString 에는 16376개의 유니코드 문자가 할당되며, 그중 15000개가 사용됩니다.
위의 값들은 다소 이상해 보일 수 있지만, 여기에는 일정한 원칙이 있습니다. 매번 크기를 두 배로 늘려가며 증가합니다. 더 정확하게 말하면, 다음 2의 거듭제곱에서 16바이트를 뺀 값으로 증가합니다. QString 은 내부적으로 UTF-16을 사용하므로, 16바이트는 8개의 문자에 해당합니다.
QByteArray 는 QString 와 동일한 알고리즘을 사용하지만, 16바이트는 16개의 문자에 해당합니다.
QList<T> 또한 해당 알고리즘을 사용하지만, 16바이트는 16/sizeof(T)개의 요소에 해당합니다.
QHash<Key, T>는 완전히 다른 경우입니다. QHash 의 내부 해시 테이블은 2의 거듭제곱 단위로 확장되며, 확장될 때마다 항목들은 qHash(key) % QHash::capacity()(버킷 수)로 계산된 새로운 버킷으로 재배치됩니다. 이 설명은 QSet<T>와 QCache<Key, T>에도 적용됩니다.
대부분의 애플리케이션에서는 Qt가 제공하는 기본 확장 알고리즘만으로도 충분합니다. 더 세밀한 제어가 필요한 경우, QList<T>, QHash<KEY, T>, QSet<T>, QString 및 QByteArray 는 항목을 저장하는 데 사용할 메모리 양을 확인하고 지정할 수 있는 세 가지 함수를 제공합니다:
- capacity()는 메모리가 할당된 항목의 수를 반환합니다( QHash 와 QSet 의 경우, 해시 테이블의 버킷 수).
- reserve(size)는 size개의 항목을 위해 메모리를 명시적으로 미리 할당합니다.
- squeeze()는 항목을 저장하는 데 필요하지 않은 메모리를 해제합니다.
컨테이너에 저장할 항목의 대략적인 수를 알고 있다면, 먼저 reserve()를 호출하여 시작할 수 있으며, 컨테이너에 항목을 모두 채운 후에는 squeeze()를 호출하여 미리 할당된 여분의 메모리를 해제할 수 있습니다.
© 2026 The Qt Company Ltd. Documentation contributions included herein are the copyrights of their respective owners. The documentation provided herein is licensed under the terms of the GNU Free Documentation License version 1.3 as published by the Free Software Foundation. Qt and respective logos are trademarks of The Qt Company Ltd. in Finland and/or other countries worldwide. All other trademarks are property of their respective owners.
