Qt Quick 场景图默认渲染器
本文档阐述了默认场景图渲染器的内部工作原理,以便开发者能够编写代码,在性能和功能方面都以最优方式利用它。
虽然无需深入理解渲染器的内部机制也能获得良好的性能,但了解其内部工作原理在与场景图集成时,或是在探究为何无法充分挖掘图形处理器的最大效率时,可能会有所帮助。
注意:即使 在每帧内容都独一无二且所有内容均从头开始上传的情况下,默认渲染器也能表现良好。
QML场景中的Qt Quick 项会填充一个由QSGNode 实例组成的树。该树一旦创建,就完整描述了特定帧应如何渲染。它完全不包含指向Qt Quick 项的任何引用,并且在大多数平台上将由单独的线程进行处理和渲染。 渲染器是场景图中一个自包含的部分,它遍历QSGNode 树,并利用在QSGGeometryNode 中定义的几何信息以及在QSGMaterial 中定义的着色器状态来更新图形状态并生成绘制调用。
如有需要,可通过内部场景图后端 API 完全替换渲染器。这主要对希望利用非标准硬件功能的平台供应商具有吸引力。对于大多数用例而言,默认渲染器已足够满足需求。
默认渲染器主要通过两种策略来优化渲染:绘制调用的批处理,以及在 GPU 上保留几何体。
批处理
传统 2D API(如QPainter 、Cairo 或Context2D )的设计目的是处理每帧数千个单独的绘制调用,而 OpenGL 及其他硬件加速 API 则在绘制调用数量极低且状态变更被控制在最小程度时表现最佳。
注意:虽然 以下各节以OpenGL 为例,但相同的概念也适用于其他图形 API。
考虑以下用例:
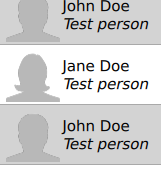
绘制此列表最简单的方法是逐单元格进行。首先绘制背景,即一个特定颜色的矩形。 用 OpenGL 的术语来说,这意味着选择一个用于纯色填充的着色器程序,设置填充颜色,设置包含 x 和 y 偏移量的变换矩阵,然后使用例如glDrawArrays 来绘制构成该矩形的两个三角形。接下来绘制图标。 用 OpenGL 的术语来说,这意味着选择一个着色器程序来绘制纹理,选择要使用的活动纹理,设置变换矩阵,启用 alpha 混合,然后使用例如glDrawArrays 来绘制构成图标边界矩形的两个三角形。 单元格中的文本和单元格之间的分隔线也遵循类似的模式。而且这个过程会针对列表中的每个单元格重复进行,因此对于较长的列表而言,OpenGL状态变更和绘制调用带来的开销,完全抵消了使用硬件加速API所能带来的好处。
当每个基元较大时,这种开销可以忽略不计,但在典型的用户界面中,存在大量小型元素,这些元素累积起来会形成相当大的开销。
默认的场景图渲染器会在这些限制内工作,并会尝试将单个基元合并为批处理,同时保持完全相同的视觉效果。这样可以减少 OpenGL 状态更改的次数,并将渲染调用量降至最低,从而实现最佳性能。
不透明基元
渲染器会区分不透明基元和需要 alpha 混合的基元。通过使用 OpenGL 的 Z 缓冲区并为每个基元分配一个唯一的 Z 位置,渲染器可以自由地重新排序不透明基元,而无需考虑它们在屏幕上的位置以及它们与哪些其他元素重叠。 通过检查每个基元的材质状态,渲染器将创建不透明批处理。根据Qt Quick 核心项目集,这包括具有不透明颜色的矩形项目以及完全不透明的图像(如JPEG或BMP)。
使用不透明基元还有另一个好处:它们不需要启用GL_BLEND ,而该功能的开销相当大,特别是在移动设备和嵌入式GPU上。
在启用glDepthMask 和GL_DEPTH_TEST 的情况下,不透明基元将按从前到后的顺序渲染。对于内部进行早期Z检测的GPU而言,这意味着对于被遮挡的像素或像素块,片段着色器无需运行。 请注意,渲染器仍需考虑这些节点,且顶点着色器仍会针对这些基元中的每个顶点运行;因此,如果应用程序已知某个对象被完全遮挡,最佳做法是使用Item::visible 或Item::opacity 将其显式隐藏。
注意: Item::z 用于控制项相对于其同级元素的堆叠顺序。它与渲染器及 OpenGL 的 Z 缓冲区没有直接关系。
带 Alpha 混合的基元
一旦不透明基元绘制完成,渲染器将禁用glDepthMask ,启用GL_BLEND ,并以由后向前的方式渲染所有带透明混合的基元。
对带透明混合的基元进行批处理需要在渲染器中投入更多工作,因为重叠的元素必须按正确顺序渲染,才能使透明混合效果正确。仅依赖 Z 缓冲区是不够的。 渲染器会对所有带透明混合的基元进行遍历,除了检查其材质状态外,还会分析其边界矩形,以此确定哪些元素可以批量渲染,哪些不能。
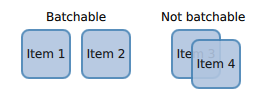
在最左侧的案例中,蓝色背景可以一次渲染完成,而两个文本元素则另行渲染,因为这些文本仅与位于其前方的背景发生重叠。 在最右侧的案例中,“Item 4”的背景与“Item 3”的文本重叠,因此在此情况下,背景和文本都需要通过单独的调用进行渲染。
在 Z 轴方向上,透明基元与不透明节点交错排列,并在可能的情况下触发早期 Z 筛选,但同样,将Item::visible 设置为 false 总是更快。
与 3D 基元混合
场景图既支持伪3D基元,也支持真正的3D基元。例如,可以通过ShaderEffect 实现“页面卷曲”效果,或通过QSGGeometry 和自定义材质实现带凹凸贴图的环面。在此过程中,需要注意默认渲染器已经使用了深度缓冲区。
渲染器会修改由 QSGMaterialShader::vertexShader() 返回的顶点着色器,并在应用模型-视图矩阵和投影矩阵后对顶点的 z 值进行压缩,随后对 z 值施加微小的平移,以将其定位到正确的 z 位置。
该压缩操作假设 z 值在 0 到 1 的范围内。
纹理图集
活动纹理是一种唯一的 OpenGL 状态,这意味着使用不同 OpenGL 纹理的多个基元无法进行批处理。因此,Qt Quick 场景图允许将多个QSGTexture 实例分配为较大纹理中的较小子区域,即纹理图集。
纹理图集的最大优势在于,多个QSGTexture 实例现在都引用同一个OpenGL纹理实例。这使得带纹理的绘制调用也能进行批处理,例如Image项、BorderImage 项、ShaderEffect 项,以及使用纹理的C++类型(如QSGSimpleTextureNode 和自定义的QSGGeometryNodes)。
注意:大型 纹理不会被纳入纹理图集。
基于纹理集的纹理是通过将QQuickWindow::TextureCanUseAtlas 传递给QQuickWindow::createTextureFromImage()来创建的。
注意: 基于纹理图集的 纹理其纹理坐标范围并非 0 到 1。请使用QSGTexture::normalizedTextureSubRect() 获取图集纹理坐标。
场景图使用启发式算法来确定图集应有多大,以及进入图集的大小阈值是多少。如果需要不同的值,可以使用环境变量QSG_ATLAS_WIDTH=[width] 、QSG_ATLAS_HEIGHT=[height] 和QSG_ATLAS_SIZE_LIMIT=[size] 来覆盖它们。更改这些值对平台供应商来说通常更有意义。
批处理根
除了将兼容的基元合并到批次中,默认渲染器还会尝试尽可能减少每帧需要发送至 GPU 的数据量。 默认渲染器会识别属于同一组的子树,并尝试将它们放入单独的批次中。一旦确定了批次,它们就会被合并、上传,并使用顶点缓冲对象(Vertex Buffer Objects)存储在 GPU 内存中。
变换节点
每个Qt Quick 项都会在场景图树中插入一个QSGTransformNode ,用于管理其x、y、缩放或旋转属性。 子项将填充在此变换节点之下。默认渲染器会在帧与帧之间跟踪变换节点的状态,并检查子树以决定某个变换节点是否适合作为一组批处理的根节点。若某个变换节点在帧与帧之间发生变化且拥有相当复杂的子树,则可能成为批处理根节点。
位于批次根节点子树中的 QSGGeometryNodes 会在 CPU 上相对于根节点进行预变换。随后它们会被上传并保存在 GPU 上。当变换发生变化时,渲染器只需更新根节点的矩阵,而无需更新每个单独的项,这使得列表和网格的滚动速度非常快。 对于连续的帧,只要节点没有被添加或移除,列表的渲染实际上是“免费”的。当新内容进入子树时,包含该内容的一批会被重建,但这一过程仍然相对较快。在网格或列表中平移时,通常每增加或移除节点的帧,都会有几帧内容保持不变。
将变换节点标识为批处理根节点的另一个好处是,它允许渲染器保留树中未发生变化的部分。 例如,假设一个用户界面由一个列表和一行按钮组成。当列表正在滚动且委托对象被添加或移除时,界面的其余部分(即按钮行)保持不变,因此可以使用已存储在 GPU 上的几何信息进行绘制。
可以通过环境变量QSG_RENDERER_BATCH_NODE_THRESHOLD=[count] 和QSG_RENDERER_BATCH_VERTEX_THRESHOLD=[count] 来覆盖转换节点成为批处理根所需的节点和顶点阈值。覆盖这些标志对平台供应商尤其有用。
注意:在 批处理根节点之下, 每组唯一材质状态和几何体类型都会创建一个批处理。
裁剪
当将Item::clip 设置为 true 时,系统会创建一个QSGClipNode ,其几何体中包含一个矩形。默认渲染器将通过 OpenGL 中的剪切(scissoring)应用此裁剪。如果项的旋转角度不是 90 度,则使用 OpenGL 的模板缓冲区。Qt Quick Item 仅支持通过 QML 将矩形设置为剪裁区域,但场景图 API 和默认渲染器可以使用任何形状进行剪裁。
当对子树应用剪裁时,该子树需要使用唯一的 OpenGL 状态进行渲染。这意味着当 `Item::clip ` 为真时,该项的批处理仅限于其子项。当子项较多(如 `ListView ` 或 `GridView`)或子项结构复杂(如 `TextArea`)时,这种做法是可行的。 然而,对于较小的控件,应谨慎使用剪切功能,因为它会阻止批量处理。这包括按钮标签、文本字段或列表委托以及表格单元格。通常可以通过调整 UI 布局来避免对 Flickable(或项目视图)进行剪切,即让不透明的控件覆盖 Flickable 周围的区域,否则可依靠窗口边缘来剪切其余内容。
将Item::clip 设置为true 也会同时设置QQuickItem::ItemIsViewport 标志;带有QQuickItem::ItemObservesViewport 标志的子项可利用视口进行粗略的预裁剪处理:例如,Text 会省略完全位于视口之外的文本行。省略场景图节点或限制vertices 是一种优化手段,可通过在C++中设置flags 来实现,而非在QML中设置Item::clip 。
在自定义项中实现 `QQuickItem::updatePaintNode()` 时,如果该项能在较大的几何区域上渲染大量细节,应考虑将图形限制在视口内是否更高效;如果是,可以设置 `ItemObservesViewport ` 标志,并从 `QQuickItem::clipRect()` 中读取当前可见的区域。 其结果之一是 updatePaintNode() 会被更频繁地调用(通常在视口内有内容移动时,每帧调用一次)。
顶点缓冲区
每个批处理都使用一个顶点缓冲区对象 (VBO) 来在 GPU 上存储其数据。该顶点缓冲区在帧与帧之间被保留,并在其所代表的场景图部分发生变化时进行更新。
默认情况下,渲染器将使用 `GL_STATIC_DRAW` 将数据上传到 VBO 中。可以通过设置环境变量 `QSG_RENDERER_BUFFER_STRATEGY=[strategy]` 来选择不同的上传策略。有效值为 `stream ` 和 `dynamic`。更改此值主要对平台供应商有用。
抗锯齿
场景图支持两种类型的抗锯齿。默认情况下,矩形和图像等基元将通过在基元边缘添加更多顶点来实现抗锯齿,使边缘逐渐过渡为透明。 我们称此方法为顶点抗锯齿。如果用户通过调用 `QQuickWindow::setFormat()` 并将 `QSurfaceFormat ` 的采样数设置为大于 `0 ` 来请求多采样 OpenGL 上下文,则场景图将优先采用基于多采样的抗锯齿(MSAA)。这两种技术会影响渲染的内部实现方式,且具有不同的限制。
此外,还可以通过将环境变量QSG_ANTIALIASING_METHOD 设置为vertex 或msaa 来覆盖所使用的抗锯齿方法。
顶点抗锯齿可能会在相邻基元边缘之间产生接缝,即使这两条边缘在数学上完全相同。而多采样抗锯齿则不会出现这种情况。
顶点抗锯齿
可以通过Item::antialiasing 属性按项目逐个启用或禁用顶点抗锯齿。无论底层硬件是否支持,该功能均可正常工作,并能为常规渲染的基元以及捕获到帧缓冲区对象中的基元(例如使用ShaderEffectSource 类型)提供更高质量的抗锯齿效果。
使用顶点抗锯齿的缺点是,每个启用了抗锯齿的基元都必须进行混合处理。 就批处理而言,这意味着渲染器需要进行更多运算来判断该基元是否可以被批处理;此外,由于与场景中其他元素的重叠,这还可能导致批处理数量减少,从而影响性能。
在低端硬件上,混合操作的开销也相当大,因此对于覆盖大部分屏幕的图像或圆角矩形,这些基元内部所需的混合量可能会导致性能大幅下降,因为必须对整个基元进行混合。
多采样抗锯齿
多采样抗锯齿是一种硬件特性,硬件会为基元中的每个像素计算覆盖值。某些硬件能够以极低的开销进行多采样,而其他硬件则可能需要更多的内存和 GPU 周期来渲染一帧画面。
通过使用多采样抗锯齿,许多基元(如圆角矩形和图像元素)既可以进行抗锯齿处理,又能在场景图中保持不透明。这意味着渲染器在创建批处理时工作更轻松,并且可以依赖早期 Z 值来避免过度绘制。
当使用多采样抗锯齿时,渲染到帧缓冲区对象中的内容需要额外的扩展来支持帧缓冲区的多采样。 通常为GL_EXT_framebuffer_multisample 和GL_EXT_framebuffer_blit 。大多数桌面芯片都具备这些扩展,但在嵌入式芯片中则较为少见。当硬件不支持帧缓冲多采样时,渲染到帧缓冲对象中的内容将不会进行抗锯齿处理,包括ShaderEffectSource 中的内容。
性能
如开头所述,要获得良好的性能,并不需要深入理解渲染器的细节。该渲染器旨在针对常见用例进行优化,几乎在任何情况下都能表现出色。
- 良好的性能源于有效的批处理,尽可能减少几何体的重复上传。 通过设置环境变量
QSG_RENDERER_DEBUG=render,渲染器将输出有关批处理效果、使用批数、哪些批次被保留以及哪些批次为不透明(opacity为0)等统计信息。在追求最佳性能时,应仅在真正需要时才进行上传,批次数应少于10,其中至少有3-4个应为不透明批次。 - 默认渲染器不会在 CPU 端进行视口裁剪或遮挡检测。如果某个对象不应可见,则不应显示。对于不应渲染的对象,请使用 `
Item::visible: false`。未添加此类逻辑的主要原因是,这会增加额外开销,从而也会影响那些在行为上表现良好的应用程序。 - 请确保使用纹理图集。除非图像过大,否则“Image”和“BorderImage ”项都会使用它。对于在 C++ 中创建的纹理,在调用 QQuickWindow::createTexture() 时请传递QQuickWindow::TextureCanUseAtlas 。通过设置环境变量
QSG_ATLAS_OVERLAY,所有图集纹理都会被着色,以便在应用程序中轻松识别。 - 尽可能使用不透明的基元。不透明基元在渲染器中的处理速度更快,在 GPU 上的绘制速度也更快。例如,PNG 文件通常包含 alpha 通道,即使每个像素都是完全不透明的。JPG 文件始终是不透明的。 在向QQuickImageProvider 提供图像或使用QQuickWindow::createTextureFromImage()创建图像时,请尽可能让图像具有QImage::Format_RGB32 属性。
- 请注意,如上图所示,重叠的复合项无法进行批量处理。
- 裁剪会中断批处理。切勿在单个项目、表格单元格、项目委托或类似场景中单独使用裁剪。裁剪文本时,请改用省略处理;裁剪图像时,请创建一个返回裁剪后图像的QQuickImageProvider 。
- 批处理仅适用于 16 位索引。所有内置项均使用 16 位索引,但自定义几何体也可自由使用 32 位索引。
- 某些材质标志会阻止批处理,其中限制最严格的是QSGMaterial::RequiresFullMatrix ,它会阻止所有批处理操作。
- 具有单色背景的应用程序应使用QQuickWindow::setColor()进行设置,而不是使用顶级Rectangle项。QQuickWindow::setColor()将在调用
glClear()时被使用,这可能会更快。 - Mipmapped Image 项目不会被放置在全局图集中,也不会被批处理。
- OpenGL 驱动程序中与帧缓冲区对象 (FBO) 读回相关的错误可能会导致渲染的字形损坏。 如果您设置了环境变量 `
QML_USE_GLYPHCACHE_WORKAROUND`,Qt 会在内存中保留该字形的额外副本。这意味着在绘制从未绘制过的字形时,性能会略有下降,因为 Qt 需要通过 CPU 访问该额外副本。这也意味着字形缓存将占用两倍的内存。但画质不会因此受到影响。
如果应用程序性能不佳,请确保渲染确实是瓶颈。请使用性能分析器!环境变量QSG_RENDER_TIMING=1 将输出一些有用的计时参数,这些参数有助于精确定位问题所在。
可变性组
有时,分析会发现渲染器将定期更新的内容与静态内容合并为一个批处理。在这种情况下,将几何体拆分为两个独立的批处理会更好,而不是在每次更新时上传一个主要包含未更改内容的大批处理。
以下是一个示例:
Column {
    Timer {
        interval: 1000
        running: true
        repeat: true
        onTriggered: dynamicText.counter++
    }

    Text {
        id: dynamicText
        property int counter: 0
        text: counter
        mutabilityGroup: Item.DynamicMutabilityGroup
    }

    Text {
        id: staticText1
        text: "Static label"
    }

    Text {
        id: staticText2
        text: "Static label"
    }
}该应用程序包含一个每秒更新的dynamicText 标签。此外,它还有两个从未更新的静态文本标签。
如果在此示例中未显式设置可变性组,静态文本标签的几何体将被与动态标签合并到同一批处理中。 这是因为它们都使用相同的材质和基本属性,而场景图批处理渲染器会尝试将显示场景中所有文本所需的绘制调用次数降至最低(在一定限度内)。因此,每当动态文本发生变化时,场景中代表静态文本的 88 个顶点都会被重新上传。
通过将dynamicText 的mutabilityGroup设置为Item.DynamicMutabilityGroup ,我们向渲染器提供了一个提示,表明该标签将被频繁更新。 因此,该标签将永远不会与属于默认可变性组( )的其余内容进行批处理。如果有多个项目以相同频率更新,仍可通过将其分配到同一组来实现批处理。
总共有 16 个可用的可变性组,包括默认组0 。
对于 UI 中绝大多数项,应使用默认可变性组。通常仅在分析发现由大型静态几何体的重新加载导致的瓶颈时,才应覆盖该默认设置。
可视化
为了可视化场景图默认渲染器的各个方面,可以将QSG_VISUALIZE 环境变量设置为以下各节中详细说明的值之一。我们通过以下QML代码提供了一些变量的输出示例:
import QtQuick 2.2

Rectangle {
    width: 200
    height: 140

    ListView {
        id: clippedList
        x: 20
        y: 20
        width: 70
        height: 100
        clip: true
        model: ["Item A", "Item B", "Item C", "Item D"]

        delegate: Rectangle {
            color: "lightblue"
            width: parent.width
            height: 25

            Text {
                text: modelData
                anchors.fill: parent
                horizontalAlignment: Text.AlignHCenter
                verticalAlignment: Text.AlignVCenter
            }
        }
    }

    ListView {
        id: clippedDelegateList
        x: clippedList.x + clippedList.width + 20
        y: 20
        width: 70
        height: 100
        clip: true
        model: ["Item A", "Item B", "Item C", "Item D"]

        delegate: Rectangle {
            color: "lightblue"
            width: parent.width
            height: 25
            clip: true

            Text {
                text: modelData
                anchors.fill: parent
                horizontalAlignment: Text.AlignHCenter
                verticalAlignment: Text.AlignVCenter
            }
        }
    }
}对于左侧的ListView ,我们将它的clip 属性设置为true 。对于右侧的ListView ,我们还将每个委托的clip 属性设置为true ,以展示裁剪对批处理的影响。

原始
注意: 可视化元素 不遵循裁剪规则,且渲染顺序是随机的。
批处理的可视化
将QSG_VISUALIZE 设置为batches 可在渲染器中可视化批处理。合并后的批处理以纯色显示,未合并的批处理则以对角线图案显示。独特的颜色越少,说明批处理效果越好。如果未合并的批处理包含大量独立节点,则说明情况不佳。

QSG_VISUALIZE=batches
裁剪可视化
将QSG_VISUALIZE 设置为clip ,会在场景上方绘制红色区域以指示剪切。由于Qt Quick 项默认不进行剪切,因此通常不会显示剪切效果。
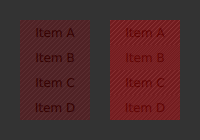
QSG_VISUALIZE=clip
可视化更改
将QSG_VISUALIZE 设置为changes 可在渲染器中可视化更改。场景图中的更改将通过随机颜色的闪烁叠加层进行可视化。基元上的更改以纯色显示,而父节点中的更改(如矩阵或不透明度更改)则以图案形式显示。
显示重绘
将 `QSG_VISUALIZE ` 设置为 `overdraw ` 可在渲染器中可视化重绘情况。通过以 3D 形式可视化所有对象来突出显示重绘区域。该模式在一定程度上也可用于检测视口外的几何体。不透明对象以绿色调渲染,半透明对象则以红色调渲染。 视口的边界框以蓝色渲染。不透明内容更容易被场景图处理,通常渲染速度也更快。
请注意,由于窗口本身也是白色的,因此上文代码中的根矩形是多余的,在此情况下绘制该矩形会浪费资源。将其改为 Item 可以略微提升性能。


QSG_VISUALIZE=overdraw
通过 Qt 渲染硬件接口(RHI)进行渲染
从 Qt 6.0 开始,默认实现始终通过图形抽象层——即由 Qt GUI 模块提供的图形抽象层——Qt 渲染硬件接口(RHI)进行。这意味着,与 Qt 5 不同,场景图不会直接调用 OpenGL。相反,它通过 RHI API 记录资源和绘制命令,随后 RHI 将命令流转换为 OpenGL、Vulkan、Metal 或 Direct 3D 调用。 着色器的处理也实现了统一:只需编写一次着色器代码,编译为SPIR-V,然后转换为适用于各种图形 API 的语言。
要控制该行为,可使用以下环境变量:
| 环境变量 | 可能的值 | 描述 |
|---|---|---|
QSG_RHI_BACKEND | vulkan,metal,opengl,d3d11,d3d12 | 请求特定的 RHI 后端。默认情况下,目标图形 API 根据平台自动选择,除非通过此变量或等效的 C++ API 进行覆盖。当前的默认值是:Windows 系统使用 Direct3D 11,macOS 系统使用 Metal,其他平台使用 OpenGL。 |
QSG_INFO | 1 | 与基于 OpenGL 的渲染路径类似,设置此选项可在初始化Qt Quick 场景图时打印系统信息。这对于故障排除非常有用。 |
QSG_RHI_DEBUG_LAYER | 1 | 在适用情况下(Vulkan、Direct3D),若图形设备或实例对象上存在图形 API 实现的调试或验证层(如有),则启用该功能。对于 macOS 上的 Metal,请改设环境变量METAL_DEVICE_WRAPPER_TYPE=1 。 |
QSG_RHI_PREFER_SOFTWARE_RENDERER | 1 | 请求选择使用基于软件的光栅化技术的适配器或物理设备。仅当底层 API 支持枚举适配器(例如 Direct3D 或 Vulkan)时才适用,否则将被忽略。 |
希望始终使用指定的单一图形 API 运行的应用程序,也可以通过 C++ 请求此功能。例如,在 main() 函数早期(在构造任何QQuickWindow 之前)进行以下调用,将强制使用 Vulkan(否则将失败):
QQuickWindow::setGraphicsApi(QSGRendererInterface::Vulkan);参见QSGRendererInterface::GraphicsApi 。枚举值OpenGL 、Vulkan 、Metal 、Direct3D11 、Direct3D12 在效果上等同于将QSG_RHI_BACKEND 设置为相应的字符串键。
所有QRhi 后端都会选择系统的默认 GPU 适配器或物理设备,除非被QSG_RHI_PREFER_SOFTWARE_RENDERER 或后端特有的变量(例如QT_D3D_ADAPTER_INDEX 或QT_VK_PHYSICAL_DEVICE_INDEX )覆盖。目前不提供其他适配器配置选项。
从 Qt 6.5 开始,某些此前仅作为环境变量暴露的设置,现可通过QQuickGraphicsConfiguration 作为 C++ API 进行访问。例如,设置QSG_RHI_DEBUG_LAYER 与调用setDebugLayer(true) 是等效的。
© 2026 The Qt Company Ltd. Documentation contributions included herein are the copyrights of their respective owners. The documentation provided herein is licensed under the terms of the GNU Free Documentation License version 1.3 as published by the Free Software Foundation. Qt and respective logos are trademarks of The Qt Company Ltd. in Finland and/or other countries worldwide. All other trademarks are property of their respective owners.
