
コンテナクラス
はじめに
QStringQtライブラリは、汎用的なテンプレートベースのコンテナクラスのセットを提供しています。これらのクラスは、指定された型の項目を格納するために使用できます。たとえば、QStringのサイズ変更可能な配列が必要な場合は、QList<XML-ph-0002@deepl.internal>を使用します。
これらのコンテナクラスは、STLのコンテナよりも軽量で、安全かつ使いやすく設計されています。STLに不慣れな場合や、「Qt流」のやり方を好む場合は、STLクラスの代わりにこれらのクラスを使用することができます。
これらのコンテナクラスは暗黙的に共有され、再入可能であり、速度、低メモリ消費、およびインラインコードの拡張を最小限に抑えるよう最適化されているため、実行ファイルのサイズが小さくなります。さらに、アクセスに使用するすべてのスレッドによって読み取り専用コンテナとして使用される状況では、スレッドセーフです。
これらのコンテナは、トラバーサル用のイテレータを提供しています。STLスタイルのイテレータが最も効率的であり、Qt XMLおよびSTLのgeneric algorithms と併用可能です。Javaスタイルのイテレータは、下位互換性を確保するために提供されています。
注: Qt 5.14以降 、ほとんどのコンテナクラスで範囲コンストラクタが利用可能になりました。QMultiMap はその顕著な例外です。Qt 5 で非推奨となった各種 from/to メソッドの代替として、範囲コンストラクタの使用が推奨されています。例:
QList<int> list = {1, 2, 3, 4, 4, 5};
QSet<int> set(list.cbegin(), list.cend());
/*
    Will generate a QSet containing 1, 2, 3, 4, 5.
*/
コンテナクラス
Qt XML では、QList 、QStack 、QQueue といった順次型コンテナが提供されています。ほとんどのアプリケーションでは、QList を使用するのが最適です。このクラスは、要素の追加処理が非常に高速です。リンクドリストがどうしても必要な場合は、std::list を使用してください。QStack およびQQueue は、LIFO および FIFO のセマンティクスを提供する利便性向上のためのクラスです。
Qt では、以下の連想コンテナも提供されています:QMap 、QMultiMap 、QHash 、QMultiHash 、およびQSet 。「Multi」コンテナは、単一のキーに複数の値を関連付けることを便利にサポートします。「Hash」コンテナは、ソート済み集合に対する二分探索の代わりにハッシュ関数を使用することで、より高速な検索を実現します。
特殊なケースとして、QCache およびQContiguousCache クラスは、限られたキャッシュ容量内でオブジェクトの効率的なハッシュ検索を実現します。
| クラス | 概要 |
|---|---|
| QList<T> | これは、最も一般的に使用されるコンテナクラスです。指定された型 (T) の値のリストを格納し、インデックスによってアクセスできます。内部的には、指定された型の値の配列を、メモリ上の隣接する位置に格納します。 リストの先頭や途中への挿入は、メモリ上で多数の要素を1つずつ移動させる必要が生じるため、処理がかなり遅くなる可能性があります。 |
| QVarLengthArray<T, Prealloc> | これは、低レベルの可変長配列を提供します。処理速度が特に重要となる場面では、QList の代わりに使用できます。 |
| QStack<T> | これは、QList の利便性を高めるサブクラスであり、「後入れ先出し(LIFO)」のセマンティクスを提供します。QList に既に存在する関数に加え、push()、pop()、およびtop()という関数が追加されています。 |
| QQueue<T> | これは、QList の利便性を高めるサブクラスであり、「先入れ先出し」(FIFO)のセマンティクスを提供します。QList に既に存在する関数に加え、enqueue()、dequeue()、およびhead()が追加されます。 |
| QSet<T> | これにより、高速な検索が可能な単一値の数学的集合が提供されます。 |
| QMap<Key, T> | これは、型 Key のキーを型 T の値にマッピングする辞書(連想配列)を提供します。通常、各キーは単一の値に関連付けられます。QMap はデータを Key の順序で格納します。順序が重要でない場合は、QHash の方が高速な代替手段となります。 |
| QMultiMap<Key, T> | これはQMap と同様の辞書を提供しますが、同一のキーを複数挿入できる点が異なります。 |
| QHash<Key, T> | これはQMap とほぼ同じ API を持っていますが、検索速度が大幅に高速です。QHash はデータを任意の順序で格納します。 |
| QMultiHash<Key, T> | これは、QHash と同様のハッシュテーブルベースの辞書を提供しますが、同一のキーを複数回挿入できる点が異なります。 |
コンテナはネスト可能です。例えば、キー型がQString で、値型がQList<int>である場合、QMap<QString 、QList<int>>といった構成を問題なく使用できます。
これらのコンテナは、コンテナと同じ名前を持つ個別のヘッダーファイル(例:<QList> )で定義されています。便宜上、これらのコンテナは<QtContainerFwd> 内で前方宣言されています。
各種コンテナに格納される値は、代入可能な任意のデータ型であることができます。条件として、型はコピーコンストラクタと代入演算子を提供している必要があります。 一部の操作では、デフォルトコンストラクタも必要です。これにより、int やdouble といった基本型、ポインタ型、QString 、QDate 、QTime といった Qt データ型など、コンテナに格納したいと思われるほとんどのデータ型がカバーされますが、QObject やQObject のサブクラス(QWidget 、QDialog 、QTimer など)はカバーされません。QList<QWidget> をインスタンス化しようとすると、コンパイラはQWidget のコピーコンストラクタおよび代入演算子が無効になっているとエラーを返します。この種のオブジェクトをコンテナに格納したい場合は、ポインタとして格納してください。例えば、QList<QWidget *> のようにします。
以下は、代入可能なデータ型の要件を満たすカスタムデータ型の例です:
class Employee
{
public:
    Employee() {}
    Employee(const Employee &other);

    Employee &operator=(const Employee &other);

private:
    QString myName;
    QDate myDateOfBirth;
};
コピーコンストラクタや代入演算子を明示的に定義しない場合、C++ ではメンバーごとにコピーを行うデフォルトの実装が提供されます。上記の例では、それだけで十分でした。 また、コンストラクタを一切定義しない場合、C++はデフォルトコンストラクタを提供し、それを使って各メンバを初期化します。明示的なコンストラクタや代入演算子は定義されていませんが、以下のデータ型はコンテナに格納することができます:
一部のコンテナは、格納可能なデータ型に対して追加の要件を設けています。例えば、QMap<Key, T>のKey型は、operator<() を満たす必要があります。このような特別な要件は、クラスの詳細な説明に記載されています。場合によっては、特定の関数に特別な要件が課されることもあり、それらは関数ごとに記述されます。 要件が満たされていない場合、コンパイラは常にエラーを出力します。
Qt XMLのコンテナは、QDataStream を使用して簡単に読み書きできるように、operator<<() および operator>>() を提供しています。これは、コンテナに格納されるデータ型も operator<<() および operator>>() をサポートしなければならないことを意味します。このようなサポートを実装するのは簡単です。上記の Movie 構造体に対して、次のように実装できます:
QDataStream &operator<<(QDataStream &out, const Movie &movie)
{
    out << (quint32)movie.id << movie.title
        << movie.releaseDate;
    return out;
}

QDataStream &operator>>(QDataStream &in, Movie &movie)
{
    quint32 id;
    QDate date;

    in >> id >> movie.title >> date;
    movie.id = (int)id;
    movie.releaseDate = date;
    return in;
}特定のコンテナクラスの関数のドキュメントでは、デフォルトコンストラクタで生成された値について言及されています。例えば、QList は自動的にその項目をデフォルトコンストラクタで生成された値で初期化し、QMap::value()は、指定されたキーがマップに存在しない場合、デフォルトコンストラクタで生成された値を返します。 ほとんどの値型の場合、これは単にデフォルトコンストラクタを使用して値が作成されることを意味します(例:QString の場合、空の文字列)。しかし、int やdouble のようなプリミティブ型、およびポインタ型については、C++ 言語では初期化が規定されていません。そのような場合、Qt のコンテナは値を自動的に 0 に初期化します。
コンテナの反復処理
範囲ベースの for
コンテナに対しては、範囲指定のfor を使用するのが望ましいです:
Qtコンテナをconstでないコンテキストで使用する場合、暗黙の共有によりコンテナが意図せず切り離されてしまう可能性があることに注意してください。これを防ぐには、std::as_const() を使用してください:
連想コンテナの場合、これにより値がループ処理されます。
インデックスベース
メモリ上に要素を連続して格納するシーケンシャルコンテナ(例:QList )では、インデックスベースの反復処理を使用できます:
QList<QString> list = {"A", "B", "C", "D"};
for (qsizetype i = 0; i < list.size(); ++i) {
    const auto &item = list.at(i);
    //...
}
イテレータクラス
イテレータは、コンテナ内の要素にアクセスするための統一的な手段を提供します。 Qtのコンテナクラスは、STLスタイルのイテレータとJavaスタイルのイテレータの2種類のイテレータを提供しています。どちらのタイプのイテレータも、コンテナ内のデータが変更された場合、または非constメンバー関数の呼び出しによって暗黙的に共有されていたコピーから切り離された場合に、無効化されます。
STL スタイルのイテレータ
STL スタイルのイテレータは、Qt 2.0 のリリース以来利用可能です。これらは Qt および STL の `generic algorithms ` と互換性があり、速度が最適化されています。
各コンテナクラスには、2種類のSTLスタイルのイテレータが用意されています。1つは読み取り専用アクセスを提供し、もう1つは読み書きアクセスを提供します。読み取り専用イテレータは、読み書きイテレータよりも高速であるため、可能な限りこれを使用すべきです。
| コンテナ | 読み取り専用イテレータ | 読み書き可能なイテレータ |
|---|---|---|
| QList<T>,QStack<T>,QQueue<T> | QList<T>::const_iterator | QList<T>::iterator |
| QSet<T> | QSet<T>::const_iterator | QSet<T>::iterator |
| QMap<Key, T>,QMultiMap<Key, T> | QMap<Key, T>::const_iterator | QMap<Key, T>::iterator |
| QHash<Key, T>,QMultiHash<Key, T> | QHash<Key, T>::const_iterator | QHash<Key, T>::iterator |
STL イテレータの API は、配列内のポインタをモデルにしています。例えば、++ 演算子はイテレータを次の要素に進め、* 演算子はイテレータが指す要素を返します。 実際、要素を隣接するメモリ位置に格納するQList やQStack の場合、iterator 型は単にT * のtypedefであり、const_iterator 型は単にconst T * のtypedefに過ぎません。
この議論では、QList およびQMap に焦点を当てます。QSet のイテレータ型は、QList のイテレータとまったく同じインターフェースを持ちます。同様に、QHash のイテレータ型は、QMap のイテレータと同じインターフェースを持っています。
以下は、QList<QString> のすべての要素を順に巡回し、小文字に変換するための典型的なループです:
QList<QString> list = {"A", "B", "C", "D"};

for (auto i = list.begin(), end = list.end(); i != end; ++i)
    *i = (*i).toLower();
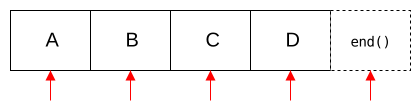
STL スタイルのイテレータは、要素を直接指します。コンテナのbegin() 関数は、コンテナ内の最初の要素を指すイテレータを返します。 コンテナの `end()` 関数は、コンテナの最後の要素の1つ先の仮想的な要素を指すイテレータを返します。`end()` は無効な位置を示しており、決して参照してはなりません。これは通常、ループの終了条件として使用されます。リストが空の場合、`begin()` は `end()` と等しくなるため、ループは実行されません。
以下の図は、4つの項目を含むリストにおける有効なイテレータの位置を赤い矢印で示しています:
STL スタイルのイテレータで逆方向に反復処理を行うには、逆イテレータを使用します:
QList<QString> list = {"A", "B", "C", "D"};

for (auto i = list.rbegin(), rend = list.rend(); i != rend; ++i)
*i = i->toLower();これまでのコードスニペットでは、単項の* 演算子を使用して、特定のイテレータ位置に格納されている項目(型はQString )を取得し、その項目に対してQString::toLower()を呼び出していました。
読み取り専用のアクセスには、const_iterator、cbegin()、およびcend() を使用できます。例えば:
for(autoi=list.cbegin(),end=list.cend(); i!=end;++i)
    qDebug() << *i;
以下の表は、STL スタイルのイテレータの API をまとめたものです。
| 式 | 動作 |
|---|---|
*i | 現在の要素を返す |
++i | イテレータを次の項目に進める |
i += n | イテレータをn 個の項目分進める |
--i | イテレータを1項目分戻す |
i -= n | イテレータをn 個分戻す |
i - j | イテレータi とj |
++ および-- 演算子は、接頭辞 (++i 、--i) および接尾辞 (i++ 、i--) 演算子の両方で利用可能です。 接頭辞形式の演算子はイテレータを変更し、変更後のイテレータへの参照を返します。一方、接尾辞形式の演算子は、イテレータを変更する前にそのコピーを作成し、そのコピーを返します。戻り値が無視される式では、接頭辞形式の演算子(++i 、--i )を使用することをお勧めします。これらはわずかに高速だからです。
非constのイテレータ型の場合、単項* 演算子の戻り値は、代入演算子の左辺で使用できます。
QMap およびQHash の場合、* 演算子は項の値成分を返します。キーを取得したい場合は、イテレータに対してkey()を呼び出します。対称性を保つため、イテレータ型には値を取得するためのvalue()関数も用意されています。例えば、QMap 内のすべての項目をコンソールに出力するには、次のようにします:
QMap<int, int>map;
//...
for(autoi=map.cbegin(),end=map.cend(); i!=end;++i)
qDebug() << i.key() << ':' << i.value();暗黙の共有のおかげで、関数がコンテナを値として返すことは非常に低コストです。 Qt API には、QList やQStringList を値として返す関数が数十個含まれています(例:QSplitter::sizes())。これらを STL イテレータを使って反復処理したい場合は、必ずコンテナのコピーを作成し、そのコピーに対して反復処理を行う必要があります。例えば:
// RIGHT
const QList<int> sizes = splitter->sizes();
for (auto i = sizes.begin(), end = sizes.end(); i != end; ++i)
    {/*...*/}

// WRONG
for (auto i = splitter->sizes().begin();
        i != splitter->sizes().end(); ++i)
    {/*...*/}
コンテナへの const または非 const の参照を返す関数では、この問題は発生しません。
暗黙の共有イテレータの問題
暗黙の共有は、STL スタイルのイテレータに対して別の影響も及ぼします。つまり、そのコンテナ上でイテレータがアクティブな間は、コンテナのコピーを避けるべきです。イテレータは内部構造体を指しており、コンテナをコピーする場合は、イテレータの扱いに細心の注意を払う必要があります。例:
QList<int> a, b;
a.resize(100000); // make a big list filled with 0.

QList<int>::iterator i = a.begin();
// WRONG way of using the iterator i:
b = a;
/*
    Now we should be careful with iterator i since it will point to shared data
    If we do *i = 4 then we would change the shared instance (both vectors)
    The behavior differs from STL containers. Avoid doing such things in Qt.
*/

a[0] = 5;
/*
    Container a is now detached from the shared data,
    and even though i was an iterator from the container a, it now works as an iterator in b.
    Here the situation is that (*i) == 0.
*/

b.clear(); // Now the iterator i is completely invalid.

int j = *i; // Undefined behavior!
/*
    The data from b (which i pointed to) is gone.
    This would be well-defined with STL containers (and (*i) == 5),
    but with QList this is likely to crash.
*/上記の例はQList の問題のみを示していますが、この問題は暗黙的に共有されるすべてのQtコンテナに存在します。
Javaスタイルのイテレータ
Javaスタイルのイテレータは、Javaのイテレータクラスをモデルにしています。新しいコードでは、STLスタイルのイテレータを優先して使用してください。
Qtコンテナとstdコンテナの比較
| Qtコンテナ | 最も近い std コンテナ |
|---|---|
| QList<T> | std::vector<T>に類似 QList およびQVector は、Qt 6で統合されました。どちらもQVector のデータモデルを使用しています。QVector は、現在QList のエイリアスとなっています。 これは、QList がリンクリストとして実装されていないことを意味します。したがって、挿入、削除、末尾への追加、先頭への追加を定数時間で実行する必要がある場合は、 |
| QVarLengthArray<T, Prealloc> | std::array<T> と std::vector<T> を組み合わせたようなものです。 パフォーマンス上の理由から、QVarLengthArray はサイズ変更が行われない限りスタック上に存在します。サイズ変更を行うと、自動的にヒープ上に配置されるようになります。 |
| QStack<T> | std::stack<T>に類似しており、QList を継承しています。 |
| QQueue<T> | std::queue<T>と同様に、QList から派生しています。 |
| QSet<T> | std::unordered_set<T>と同様です。内部的には、QSet はQHash を用いて実装されています。 |
| QMap<Key, T> | std::map<Key, T>と同様です。 |
| QMultiMap<Key, T> | std::multimap<Key, T>と同様です。 |
| QHash<Key, T> | std::unordered_map<Key, T>に最も類似しています。 |
| QMultiHash<Key, T> | std::unordered_multimap<Key, T> に最も類似しています。 |
Qtのコンテナとstdアルゴリズム
#include <algorithm> に含まれる関数と組み合わせて、Qt コンテナを使用することができます。
QList<int> list = {2, 3, 1};

std::sort(list.begin(), list.end());
/*
    Sort the list, now contains { 1, 2, 3 }
*/

std::reverse(list.begin(), list.end());
/*
    Reverse the list, now contains { 3, 2, 1 }
*/

int even_elements =
        std::count_if(list.begin(), list.end(), [](int element) { return (element % 2 == 0); });
/*
    Count how many elements that are even numbers, 1
*/
Qt コンテナのアルゴリズム
また、Qtでは<QtAlgorithms> に、STLスタイルのイテレータをサポートするあらゆるコンテナで動作する追加の汎用アルゴリズムも提供しています。例えば、コンテナの要素を単一の値に結合するqJoin()や、コンテナ内のすべての項目または指定された範囲の項目に対してoperator delete を呼び出すqDeleteAll()などがあります。
その他のコンテナ風クラス
Qt には、いくつかの点でコンテナに似た他のテンプレートクラスも含まれています。これらのクラスはイテレータを提供しておらず、foreach キーワードとともに使用することはできません。
- QCache<Key, T> は、Key 型のキーに関連付けられた特定の型 T のオブジェクトを格納するためのキャッシュを提供します。
- QContiguousCache<T>は、通常、連続した形でアクセスされるデータを効率的にキャッシュする手段を提供します。
Qtのテンプレートコンテナと競合するその他の非テンプレート型としては、QBitArray 、QByteArray 、QString 、およびQStringList があります。
アルゴリズムの計算量
アルゴリズムの計算量は、コンテナ内の要素数が増加するにつれて、各関数がどれほど高速(あるいは低速)に動作するかを扱うものです。 たとえば、std::list の途中へ要素を挿入する操作は、リストに格納されている要素の数に関係なく、極めて高速です。一方、QList の途中へ要素を挿入する場合、QList に多くの要素が含まれていると、要素の半分をメモリ上で 1 ポジション分移動させる必要があるため、処理コストが非常に高くなる可能性があります。
アルゴリズムの計算量を記述するために、「ビッグオー」表記に基づいた以下の用語を使用します。
- 定数時間:O(1)。関数が定数時間で実行されるとは、コンテナ内の要素数がいくら多くても、必要な時間が一定であることを指します。一例として、QList::push_back() が挙げられます。
- 対数時間:O(logn)。対数時間で実行される関数とは、コンテナ内の要素数の対数に比例して実行時間が決まる関数のことです。一例として、二分探索アルゴリズムが挙げられます。
- 線形時間:O(n)。線形時間で実行される関数は、コンテナに格納されている要素の数に正比例する時間で実行されます。一例として、QList::insert() が挙げられます。
- 線形対数時間:O(nlogn)。線形対数時間で実行される関数は、線形時間の関数よりも漸近的に遅いですが、二次時間の関数よりは速いです。
- 2次時間:O(n²)。2次時間で実行される関数は、コンテナに格納されている要素数の2乗に比例する時間で実行されます。
以下の表は、順次コンテナQList<T>のアルゴリズム的複雑度をまとめたものです:
| インデックス検索 | 挿入 | 先頭への挿入 | 末尾への追加 | |
|---|---|---|---|---|
| QList<T> | O(1) | O(n) | O(n) | 平均 O(1) |
この表において、「Amort.」は「償却時間」を意味します。 例えば、「Amort. O(1)」とは、関数を1回だけ呼び出した場合はO(n)の挙動となる可能性がありますが、複数回(例えばn回)呼び出した場合の平均的な挙動はO(1)になることを意味します。
以下の表は、Qtの連想コンテナおよびセットのアルゴリズム的計算複雑度をまとめたものです:
| キーの検索 | 挿入 | |||
|---|---|---|---|---|
| 平均 | 最悪ケース | 平均 | 最悪の場合 | |
| QMap<Key, T> | O(logn) | O(logn) | O(logn) | O(logn) |
| QMultiMap<Key, T> | O(logn) | O(logn) | O(logn) | O(logn) |
| QHash<Key, T> | 平均時間 O(1) | O(n) | 平均 O(1) | O(n) |
| QSet<Key> | 平均時間 O(1) | O(n) | 平均時間 O(1) | O(n) |
QList 、QHash 、およびQSet を使用する場合、要素の追加処理のパフォーマンスは平均O(logn)となります。要素を挿入する前に、予想される要素数を引き数としてQList::reserve()、QHash::reserve()、またはQSet::reserve()を呼び出すことで、これをO(1)まで低減できます。次のセクションでは、このトピックについてさらに詳しく説明します。
プリミティブ型およびリロケータブル型の最適化
Qtのコンテナは、格納される要素がリロケータブル型、あるいはプリミティブ型である場合、最適化されたコードパスを使用できます。ただし、型がプリミティブ型かリロケータブル型であるかどうかは、すべてのケースで検出できるわけではありません。Q_DECLARE_TYPEINFO マクロにQ_PRIMITIVE_TYPEフラグまたはQ_RELOCATABLE_TYPEフラグを指定することで、型をプリミティブ型またはリロケータブル型として宣言できます。詳細および使用例については、Q_DECLARE_TYPEINFO のドキュメントを参照してください。
Q_DECLARE_TYPEINFO を使用しない場合、Qt はstd::is_trivial_v<T>を使用してプリミティブ型を識別し、std::is_trivially_copyable_v<T>とstd::is_trivially_destructible_v<T>の両方を満たす型をリロケータブル型として識別します。 これは、パフォーマンスの面で必ずしも最適とは言えないかもしれませんが、常に安全な選択です。
成長戦略
QList<T>、QString 、およびQByteArray は、アイテムをメモリ内に連続して格納します。一方、QHash<Key, T> は、ハッシュ内のアイテム数に比例したサイズのハッシュテーブルを保持します。コンテナの末尾にアイテムが追加されるたびにデータの再割り当てが行われるのを避けるため、これらのクラスは通常、必要以上に多くのメモリを割り当てます。
次のコードを考えてみましょう。これは、あるQString から別のQString を構築するものです:
QString onlyLetters(const QString &in)
{
    QString out;
    for (qsizetype j = 0; j < in.size(); ++j) {
        if (in.at(j).isLetter())
            out += in.at(j);
    }
    return out;
}
out という文字列を、1文字ずつ追加していくことで動的に構築します。QString という文字列に15000文字を追加すると仮定しましょう。その場合、QString の空き領域が不足すると、以下の11回のreallocation(最大15000回のうち)が発生します:8、24、56、120、248、504、 1016、2040、4088、8184、16376。最終的に、QString には16376個のUnicode文字が割り当てられ、そのうち15000個が使用されています。
上記の数値は少し奇妙に思えるかもしれませんが、そこには一定の原則があります。それは、毎回サイズを2倍にして増加していくというものです。より正確には、次の2の冪から16バイトを引いた値へと増加していきます。QString は内部でUTF-16を使用しているため、16バイトは8文字に相当します。
QByteArray はQString と同じアルゴリズムを使用していますが、16バイトは16文字に対応します。
QList<T>もこのアルゴリズムを使用しますが、16バイトは16/sizeof(T)個の要素に相当します。
QHash<Key, T> は全く異なるケースです。QHash の内部ハッシュテーブルは 2 の累乗ごとに拡張され、拡張のたびに、要素は新しいバケットに再配置されます。新しいバケットは、qHash(key) %QHash::capacity()(バケット数)として計算されます。この説明は、QSet<T> およびQCache<Key, T> にも当てはまります。
ほとんどのアプリケーションでは、Qt が提供するデフォルトの拡張アルゴリズムで十分です。より詳細な制御が必要な場合は、QList<T>、QHash<KEY, T>、QSet<T>、QString 、およびQByteArray の 3 つの関数を使用することで、アイテムの格納に使用するメモリ量を調べたり指定したりすることができます。
- capacity() は、メモリが割り当てられる項目の数を返します(QHash およびQSet の場合、ハッシュテーブルのバケット数)。
- reserve(size) は、size個のアイテム分のメモリを明示的に事前割り当てします。
- squeeze() は、項目の格納に不要なメモリを解放します。
コンテナに格納する項目の数がおおよそ分かっている場合は、まずreserve() を呼び出し、コンテナへのデータの格納が完了したら、squeeze() を呼び出して、余分な事前割り当てメモリを解放することができます。
© 2026 The Qt Company Ltd. Documentation contributions included herein are the copyrights of their respective owners. The documentation provided herein is licensed under the terms of the GNU Free Documentation License version 1.3 as published by the Free Software Foundation. Qt and respective logos are trademarks of The Qt Company Ltd. in Finland and/or other countries worldwide. All other trademarks are property of their respective owners.
