
AI翻译
AI 翻译功能允许您利用大型语言模型(LLM)为打开的 TS 文件自动生成翻译。 您可以使用本地 LLM 服务器(例如Ollama、LM Studio 或llama.cpp),也可以使用支持 OpenAI 兼容 REST 协议的云端 API(例如 OpenAI、Groq 或 Anthropic)。
Qt Linguist 支持两种 API 模式:
- Ollama- Ollama 的原生 REST API。在本地运行Ollama时请使用此模式。
- OpenAI 兼容模式- 标准的 OpenAI REST API 格式。适用于以下情况:
- 本地服务器:LM Studio、llama.cpp 或 Ollama(Ollama 同时也支持 OpenAI 兼容模式)
- 云服务提供商:OpenAI、Groq、DeepSeek 等
设置本地 LLM 服务器
若要通过本地服务器使用 AI 翻译功能,请安装以下任一软件,并下载至少一个模型:
注意:在本地运行 大型语言模型(LLM)需要足够的内存,具体取决于模型大小和量化级别。请参阅您所使用的 LLM 服务器的文档以了解具体要求,例如《LM Studio 系统要求》。
对于 Ollama,请使用命令行拉取模型:
ollama pull qwen3:14b
ollama serve
对于 LM Studio,请通过应用程序界面下载模型并启动本地服务器:
lms server start对于 llama.cpp,您可以使用内置的模型预设之一:
llama-server --fim-qwen-7b-default或者下载一个 GGUF 模型文件并手动启动服务器:
llama-server -m model.gguf --port 8080使用云API
要使用基于云的翻译服务,请将 API 类型选为“OpenAI 兼容”,输入服务提供商的 API 端点 URL,并提供您的 API 密钥。
请仅输入基础 URL,不要包含/v1 路径后缀。例如,对于OpenRouter,请使用https://openrouter.ai/api 。请查阅服务提供商的文档以获取正确的端点 URL。
使用“AI 翻译”对话框
在 Linguist 中,选择Tools > AI Translation 以打开“AI 翻译”对话框:
对话框中的“Configuration ”部分提供以下功能:
- API Type:若使用本地 Ollama 服务器并采用 Ollama 原生 API,请选择“xml-ph-0000@deepl.internal”;若使用 LM Studio、llama.cpp、云 API 或处于 OpenAI 兼容模式的 Ollama,请选择“OpenAI Compatible”。
- Server URL:服务器监听的基 URL。请勿包含
/v1路径后缀。默认值:Ollama 为http://localhost:11434,OpenAI Compatible 为http://localhost:8080。 - API Key: 云 API 的身份验证密钥(本地服务器可选)。
- Model: 可用模型的下拉列表。
- Context: 可选的应用上下文,用于提高翻译准确性(例如,“医疗软件”、“视频游戏”、“金融应用”)。
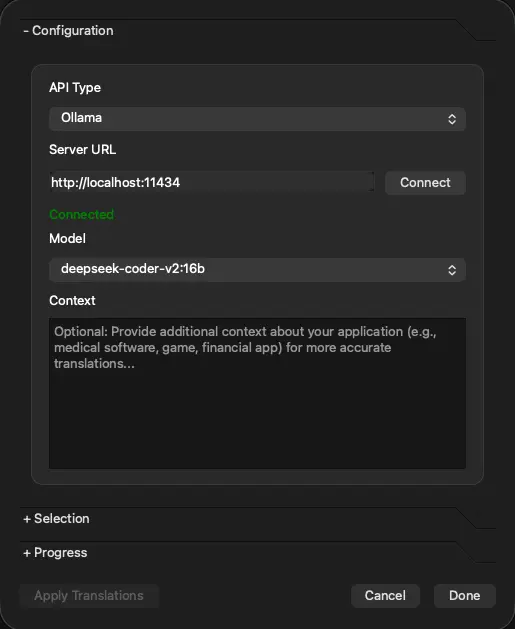
对话框中的“Selection ”部分提供:
- File: 待翻译的 TS 文件。
- Filter: 将翻译范围限定在特定组(上下文或标签)内。
- Translate: 启动 AI 翻译。
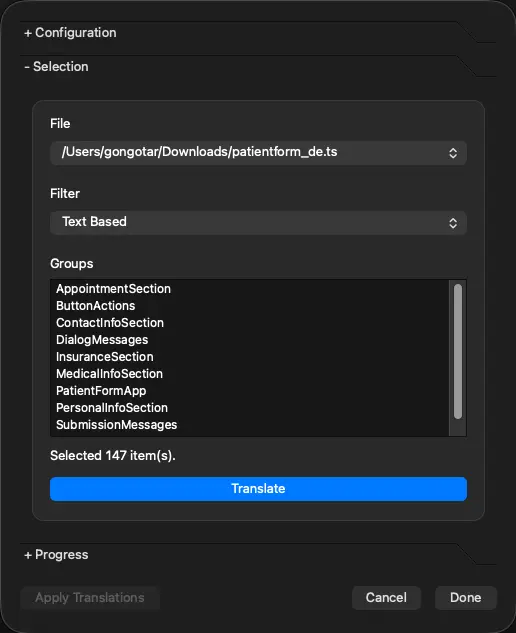
对话框中的“Progress ”部分提供:
- 一个停止按钮,用于停止翻译进程
- Apply Translations:将已翻译的项目应用到 TS 文件中。
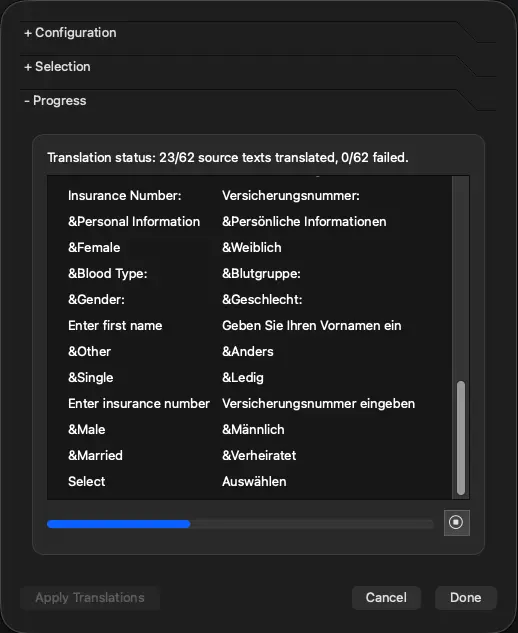
翻译过程中,“Translation Log ”中会显示进度提示。完成后,请在日志中检查已翻译的文本。点击“Apply Translations ”将AI生成的译文插入到TS文件中。
安全注意事项
AI 翻译会通过网络将数据发送至您配置的服务器。在使用前,请考虑以下事项:
- 请勿将机密字符串存储在远程服务器上。 Qt Linguist 会将待翻译的源字符串以及您提供的任何Context 发送至配置好的服务器。请仅使用您信任的服务器,并优先选择本地 LLM 服务器。
- 在应用 AI 生成的翻译前请先审核。 Qt Linguist 会原样插入服务器的翻译结果。请将其视为不可信内容,并在选择Apply Translations 之前,通过Translation Log 进行审核,因为这些内容可能包含意外的标记或格式指定符。
- 对于远程服务器,应优先使用 HTTPS。 Qt Linguist 会将 API 密钥作为承载令牌(bearer token)包含在请求中。如果Server URL 使用
http而不是https,网络路径上的任何人都可以读取明文形式的密钥和源文本。对于任何未在本地机器上运行的服务器,请使用https。
推荐型号
以下模型在翻译任务中值得推荐,它们在质量、速度和资源使用方面取得了平衡。这些模型可在以下位置找到:
- Ollama- 按模型名称搜索(例如:
ollama pull qwen3:14b) - LM Studio- 在模型浏览器中搜索
- Hugging Face- 下载适用于 llama.cpp 的 GGUF 文件
| 模型 | 大小 | 备注 |
|---|---|---|
| Mistral Small 24B | 14 GB | 翻译质量高,具备强大的多语言支持。为获得最佳性能,需配备 >16 GB 显存。 |
| Qwen3 14B | 9 GB | 在质量与资源消耗之间取得平衡。支持100多种语言。 |
| Qwen3 30B | 19 GB | 高质量的翻译。采用MoE架构,实现高效推理。 |
| Qwen2.5 14B | 9 GB | 强大的多语言支持,涵盖29种以上语言,包括中日韩语言。 |
| Gemma 3 12B | 8 GB | 支持 140 多种语言。适用于资源受限的系统。 |
| 7shi/llama-translate 8B | 5 GB | 专为英语、法语、中文和日语设计的翻译模型。适用于硬件资源有限的轻量级方案。仅在Ollama上提供。 |
对于资源有限的系统,Qwen3 8B(5 GB)或 Qwen2.5 7B(5 GB)等较小版本在保证合理翻译质量的同时,对内存的需求更低。
注意:翻译 质量因语言对和模型而异。请测试不同模型,以找到最适合您具体翻译需求的速率、质量和资源使用率的最佳组合。
© 2026 The Qt Company Ltd. Documentation contributions included herein are the copyrights of their respective owners. The documentation provided herein is licensed under the terms of the GNU Free Documentation License version 1.3 as published by the Free Software Foundation. Qt and respective logos are trademarks of The Qt Company Ltd. in Finland and/or other countries worldwide. All other trademarks are property of their respective owners.
