
容器类
简介
QStringQt 库提供了一组基于模板的通用容器类。这些类可用于存储指定类型的项目。例如,如果您需要一个可调整大小的 `QString` 数组,请使用 `QList<XML-ph-0002@deepl.internal>`。
这些容器类的设计旨在比 STL 容器更轻量、更安全且更易于使用。如果您不熟悉 STL,或者更倾向于采用“Qt 式”的做法,可以使用这些类来替代 STL 类。
这些容器类默认共享,支持重入,并且经过优化以实现高速运行、低内存消耗和最小内联代码扩展,从而生成更小的可执行文件。此外,当所有访问它们的线程均将其用作只读容器时,它们是线程安全的。
这些容器提供了用于遍历的迭代器。STL风格的迭代器效率最高,可与Qt XML和STL的generic algorithms 配合使用。Java风格的迭代器是为了向后兼容而提供的。
注意:自 Qt 5.14起, 大多数容器类都支持范围构造函数。QMultiMap 是一个值得注意的例外。建议使用这些构造函数来替代 Qt 5 中已弃用的各种 from/to 方法。例如:
QList<int> list = {1, 2, 3, 4, 4, 5};
QSet<int> set(list.cbegin(), list.cend());
/*
    Will generate a QSet containing 1, 2, 3, 4, 5.
*/
容器类
Qt 提供了以下顺序容器:QList 、QStack 和QQueue 。对于大多数应用程序而言,QList 是最佳选择。它提供了非常快速的追加操作。如果您确实需要链表,请使用 std::list。QStack 和QQueue 是提供 LIFO 和 FIFO 语义的便捷类。
QMap 、QMultiMap 、QHash 、QMultiHash 以及QSet 。“Multi” 容器可方便地支持单个键关联多个值。“Hash” 容器通过使用哈希函数(而非对排序集合进行二进制搜索)来提供更快的查找速度。
作为特例,QCache 和QContiguousCache 类可在有限的缓存空间内对对象进行高效的哈希查找。
| 类 | 摘要 |
|---|---|
| QList<T> | 这是迄今为止使用最广泛的容器类。它存储一组指定类型(T)的值,可通过索引进行访问。在内部,它将指定类型的值存储在内存中相邻的位置上,形成一个数组。 在列表开头或中间插入元素可能会非常慢,因为这可能会导致大量元素在内存中需要向后移动一个位置。 |
| QVarLengthArray<T, Prealloc> | 该类提供了一个低级别的可变长度数组。在对速度要求特别高的场景中,可将其用于替代QList 。 |
| QStack<T> | 这是QList 的一个便捷子类,提供“后进先出”(LIFO)语义。它在QList 已有的函数基础上,增加了以下函数:push()、pop()和top()。 |
| QQueue<T> | 这是一个QList 的便捷子类,提供“先进先出”(FIFO)语义。它在QList 中已有的函数基础上,新增了以下函数:enqueue()、dequeue() 和head()。 |
| QSet<T> | 这提供了一个支持快速查找的单值数学集合。 |
| QMap<Key, T> | 这提供了一个字典(关联数组),将类型为 Key 的键映射到类型为 T 的值。通常,每个键与一个值相关联。QMap 按 Key 的顺序存储数据;如果顺序无关紧要,QHash 是一个更快的替代方案。 |
| QMultiMap<Key, T> | 这提供了一个与QMap 类似的字典,不同之处在于它允许插入多个等价键。 |
| QHash<Key, T> | 其 API 与QMap 几乎相同,但查找速度显著更快。QHash 按任意顺序存储数据。 |
| QMultiHash<Key, T> | 它提供了一个基于哈希表的字典,类似于 `QHash`,不同之处在于它允许插入多个等价键。 |
容器可以嵌套。例如,完全可以使用QMap<QString ,QList<int>>,其中键类型为QString ,值类型为QList<int>。
这些容器在与容器同名的独立头文件中定义(例如,<QList> )。为方便起见,这些容器在<QtContainerFwd> 中进行了前向声明。
存储在各种容器中的值可以是任何可赋值的数据类型。要符合这一要求,类型必须提供一个复制构造函数和一个赋值运算符。 对于某些操作,还要求提供默认构造函数。这涵盖了您可能希望存储在容器中的大多数数据类型,包括基本类型(如int 和double )、指针类型,以及 Qt 数据类型(如QString 、QDate 和QTime ),但不包括QObject 或任何QObject 的子类(如QWidget 、QDialog 、QTimer 等)。 如果您尝试实例化QList<QWidget>,编译器会报错,指出QWidget 的复制构造函数和赋值运算符已被禁用。如果您想将此类对象存储在容器中,请以指针形式存储,例如QList<QWidget *>。
以下是一个满足可赋值数据类型要求的自定义数据类型示例:
class Employee
{
public:
    Employee() {}
    Employee(const Employee &other);

    Employee &operator=(const Employee &other);

private:
    QString myName;
    QDate myDateOfBirth;
};
如果我们未提供复制构造函数或赋值运算符,C++ 会提供默认实现,该实现会逐成员进行复制。在上面的示例中,这样就足够了。 此外,如果未提供任何构造函数,C++ 会提供一个默认构造函数,该构造函数使用默认构造函数来初始化其成员。尽管未提供任何显式构造函数或赋值运算符,但以下数据类型仍可存储在容器中:
某些容器对其可存储的数据类型有额外要求。例如,QMap<Key, T> 的 Key 类型必须提供operator<() 。此类特殊要求会在类的详细描述中说明。在某些情况下,特定函数会有特殊要求;这些要求会针对每个函数分别说明。 如果未满足某项要求,编译器将始终报错。
Qt 的容器提供了 operator<<() 和 operator>>(),以便能够使用QDataStream 轻松地读写数据。这意味着容器中存储的数据类型也必须支持 operator<<() 和 operator>>()。提供此类支持非常简单;以下是针对上述 Movie 结构体实现的方法:
QDataStream &operator<<(QDataStream &out, const Movie &movie)
{
    out << (quint32)movie.id << movie.title
        << movie.releaseDate;
    return out;
}

QDataStream &operator>>(QDataStream &in, Movie &movie)
{
    quint32 id;
    QDate date;

    in >> id >> movie.title >> date;
    movie.id = (int)id;
    movie.releaseDate = date;
    return in;
}某些容器类函数的文档中提到了默认构造的值;例如,QList 会自动使用默认构造的值初始化其项,而QMap::value() 若指定的键不在映射中,则返回一个默认构造的值。 对于大多数值类型,这仅仅意味着使用默认构造函数创建一个值(例如,对于 `QString`,即创建一个空字符串)。但对于像 `int ` 和 `double` 这样的基本类型,以及指针类型,C++ 语言并未规定任何初始化方式;在这些情况下,Qt 的容器会自动将值初始化为 0。
遍历容器
基于范围的 for 循环
对于容器,最好使用基于范围的for :
请注意,在非 const 上下文中使用 Qt 容器时,隐式共享可能会导致容器被意外分离。为防止这种情况,请使用std::as_const() :
对于关联容器,这将遍历其中的所有值。
基于索引
对于将项目连续存储在内存中的顺序容器(例如,QList ),可以使用基于索引的迭代:
QList<QString> list = {"A", "B", "C", "D"};
for (qsizetype i = 0; i < list.size(); ++i) {
    const auto &item = list.at(i);
    //...
}
迭代器类
迭代器提供了一种访问容器中项的统一方式。 Qt 的容器类提供了两种类型的迭代器:STL 风格迭代器和 Java 风格迭代器。当容器中的数据被修改,或者因调用非 const 成员函数而与隐式共享的副本脱离时,这两种类型的迭代器都会失效。
STL 风格的迭代器
STL 风格的迭代器自 Qt 2.0 发布以来便已可用。它们与 Qt 和 STL 的generic algorithms 兼容,并经过了速度优化。
对于每个容器类,都有两种 STL 风格的迭代器类型:一种提供只读访问,另一种提供读写访问。应尽可能使用只读迭代器,因为它们比读写迭代器运行速度更快。
| 容器 | 只读迭代器 | 读写迭代器 |
|---|---|---|
| QList<T>,QStack<T>,QQueue<T> | QList<T>::const_iterator | QList<T>::iterator |
| QSet<T> | QSet<T>::const_iterator | QSet<T>::iterator |
| QMap<Key, T>,QMultiMap<Key, T> | QMap<Key, T>::const_iterator | QMap<Key, T>::iterator |
| QHash<Key, T>,QMultiHash<Key, T> | QHash<Key, T>::const_iterator | QHash<Key, T>::iterator |
STL 迭代器的 API 是以数组中的指针为模型设计的。例如,++ 运算符将迭代器向前移动到下一个项,而* 运算符返回迭代器所指向的项。 实际上,对于将元素存储在相邻内存位置的QList 和QStack 而言,iterator 类型只是T * 的typedef,而const_iterator 类型只是const T * 的typedef。
在本节讨论中,我们将重点关注QList 和QMap 。QSet 的迭代器类型与QList 的迭代器具有完全相同的接口;同样,QHash 的迭代器类型也与QMap 的迭代器具有相同的接口。
以下是一个典型的循环示例,用于按顺序遍历QList<QString>中的所有元素并将它们转换为小写:
QList<QString> list = {"A", "B", "C", "D"};

for (auto i = list.begin(), end = list.end(); i != end; ++i)
    *i = (*i).toLower();
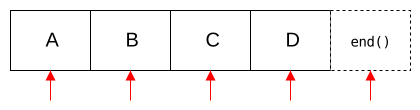
STL 风格的迭代器直接指向元素。容器的begin() 函数返回一个指向容器中第一个元素的迭代器。 容器的 `end()` 函数返回一个迭代器,该迭代器指向容器中最后一个元素之后一个位置的虚拟元素。`end()` 表示一个无效位置;绝不能对其进行解引用。它通常用于循环的 `break` 条件中。如果列表为空,则 `begin()` 等于 `end()`,因此循环永远不会执行。
下图用红色箭头标出了一个包含四个元素的列表中有效的迭代器位置:
使用 STL 风格的迭代器进行反向迭代需借助反向迭代器:
QList<QString> list = {"A", "B", "C", "D"};

for (auto i = list.rbegin(), rend = list.rend(); i != rend; ++i)
*i = i->toLower();在之前的代码片段中,我们使用了单目* 运算符来获取存储在特定迭代器位置处的元素(类型为QString ),然后对其调用QString::toLower()方法。
对于只读访问,可以使用 const_iterator、cbegin() 和cend()。例如:
for(autoi=list.cbegin(),end=list.cend(); i!=end;++i)
    qDebug() << *i;
下表总结了 STL 风格迭代器的 API:
| 表达式 | 行为 |
|---|---|
*i | 返回当前项 |
++i | 将迭代器移动到下一个元素 |
i += n | 将迭代器向前移动n 个项目 |
--i | 将迭代器向后移动一个项目 |
i -= n | 将迭代器向后移动n 个项目 |
i - j | 返回迭代器i 和j |
++ 和-- 运算符既有前缀形式(++i 、--i ),也有后缀形式(i++ 、i-- )。 前缀版本会修改迭代器并返回被修改迭代器的引用;后缀版本则会在修改迭代器之前先复制该迭代器,并返回该副本。在忽略返回值的表达式中,建议使用前缀运算符(++i 、--i ),因为它们的速度稍快一些。
对于非 const 迭代器类型,一元* 运算符的返回值可用于赋值运算符的左侧。
对于QMap 和QHash ,* 运算符返回项的值部分。若要获取键,请在迭代器上调用key()。出于对称性考虑,迭代器类型还提供了value()函数来获取值。例如,以下是将QMap 中的所有项打印到控制台的方法:
QMap<int, int>map;
//...
for(autoi=map.cbegin(),end=map.cend(); i!=end;++i)
qDebug() << i.key() << ':' << i.value();得益于隐式共享,函数按值返回一个容器所需的开销非常小。 Qt API 中包含数十个按值返回 `QList ` 或 `QStringList ` 的函数(例如,`QSplitter::sizes()`)。如果你想使用 STL 迭代器遍历这些容器,应始终先复制该容器,然后对副本进行遍历。例如:
// RIGHT
const QList<int> sizes = splitter->sizes();
for (auto i = sizes.begin(), end = sizes.end(); i != end; ++i)
    {/*...*/}

// WRONG
for (auto i = splitter->sizes().begin();
        i != splitter->sizes().end(); ++i)
    {/*...*/}
对于返回容器 const 或非 const 引用(const 或 non-const reference)的函数,则不会出现此问题。
隐式共享迭代器问题
隐式共享对 STL 风格的迭代器还有另一个影响:当迭代器在容器上处于活动状态时,应避免复制该容器。迭代器指向的是内部结构,如果复制容器,则需格外小心处理迭代器。例如:
QList<int> a, b;
a.resize(100000); // make a big list filled with 0.

QList<int>::iterator i = a.begin();
// WRONG way of using the iterator i:
b = a;
/*
    Now we should be careful with iterator i since it will point to shared data
    If we do *i = 4 then we would change the shared instance (both vectors)
    The behavior differs from STL containers. Avoid doing such things in Qt.
*/

a[0] = 5;
/*
    Container a is now detached from the shared data,
    and even though i was an iterator from the container a, it now works as an iterator in b.
    Here the situation is that (*i) == 0.
*/

b.clear(); // Now the iterator i is completely invalid.

int j = *i; // Undefined behavior!
/*
    The data from b (which i pointed to) is gone.
    This would be well-defined with STL containers (and (*i) == 5),
    but with QList this is likely to crash.
*/上述示例仅展示了QList 的问题,但该问题同样存在于所有隐式共享的 Qt 容器中。
Java 风格的迭代器
Java 风格的迭代器是参照 Java 的迭代器类设计的。新代码应优先使用STL 风格的迭代器。
Qt 容器与 std 容器的比较
| Qt 容器 | 最接近的 std 容器 |
|---|---|
| QList<T> | 类似于 std::vector<T> QList 和QVector 在 Qt 6 中已合并。两者均采用QVector 中的数据模型。QVector 现已成为QList 的别名。 这意味着QList 并非以链表形式实现,因此若您需要常数时间复杂度的插入、删除、追加或前缀操作,请考虑使用 |
| QVarLengthArray<T, Prealloc> | 类似于 std::array<T> 和 std::vector<T> 的混合体。 出于性能考虑,除非进行调整大小操作,否则QVarLengthArray 始终驻留在栈上。调整其大小会自动使其转为使用堆内存。 |
| QStack<T> | 与 std::stack<T> 类似,继承自QList 。 |
| QQueue<T> | 与 std::queue<T> 类似,继承自QList 。 |
| QSet<T> | 与 std::unordered_set<T> 类似。在内部,QSet 是通过QHash 实现的。 |
| QMap<Key, T> | 类似于 std::map<Key, T>。 |
| QMultiMap<Key, T> | 类似于 std::multimap<Key, T>。 |
| QHash<Key, T> | 与 std::unordered_map<Key, T> 最为相似。 |
| QMultiHash<Key, T> | 与 std::unordered_multimap<Key, T> 最为相似。 |
Qt 容器与 std 算法
您可以将 Qt 容器与#include <algorithm> 中的函数结合使用。
QList<int> list = {2, 3, 1};

std::sort(list.begin(), list.end());
/*
    Sort the list, now contains { 1, 2, 3 }
*/

std::reverse(list.begin(), list.end());
/*
    Reverse the list, now contains { 3, 2, 1 }
*/

int even_elements =
        std::count_if(list.begin(), list.end(), [](int element) { return (element % 2 == 0); });
/*
    Count how many elements that are even numbers, 1
*/
Qt 容器算法
Qt XML 还在<QtAlgorithms> 中提供了额外的通用算法,这些算法可与任何支持 STL 风格迭代器的容器配合使用,例如用于将容器元素合并为单一值的 `qJoin()`,以及用于对容器中的所有项或指定范围内的项调用 `operator delete ` 的 `qDeleteAll()`。
其他容器类
Qt 还包含其他在某些方面类似于容器的模板类。这些类不提供迭代器,且无法与foreach 关键字一起使用。
- QCache<Key, T> 提供了一个缓存,用于存储与 Key 类型键关联的特定类型 T 的对象。
- QContiguousCache<T> 提供了一种高效的方式,用于缓存通常以连续方式访问的数据。
与 Qt 模板容器竞争的其他非模板类型包括QBitArray 、QByteArray 、QString 和QStringList 。
算法复杂度
QList 算法复杂度关注的是,随着容器中项数的增加,每个函数的执行速度有多快(或多慢)。 例如,将一个元素插入到 std::list 的中间是一项极其快速的操作,无论列表中存储了多少个元素。另一方面,如果QList 包含许多元素,将其插入到 的中间可能会非常耗时,因为必须将一半的元素在内存中向后移动一个位置。
为了描述算法复杂度,我们基于“大O”表示法使用以下术语:
- 常数时间:O(1)。如果一个函数无论容器中包含多少个元素,所需时间都相同,则称该函数的运行时间为常数时间。一个例子是QList::push_back()。
- 对数时间:O(logn)。运行时间为对数级的函数是指其运行时间与容器中项数的对数成正比的函数。一个例子是二分搜索算法。
- 线性时间:O(n)。线性时间运行的函数,其执行时间与容器中存储的元素个数成正比。一个例子是QList::insert()。
- 线性-对数时间:O(nlogn)。运行时间为线性-对数时间的函数,其运行速度渐近上慢于线性时间函数,但快于二次时间函数。
- 二次时间:O(n²)。二次时间函数的执行时间与容器中存储的元素数量的平方成正比。
下表总结了顺序容器QList<T> 的算法复杂度:
| 索引查找 | 插入 | 前缀插入 | 追加 | |
|---|---|---|---|---|
| QList<T> | O(1) | O(n) | O(n) | 摊还时间复杂度 O(1) |
在表格中,“Amort.”代表“摊还行为”。 例如,“摊还 O(1)”意味着:如果仅调用该函数一次,其行为可能是 O(n);但如果调用多次(例如n次),其平均行为将为 O(1)。
下表总结了 Qt 中关联容器和集合的算法复杂度:
| 键查找 | 插入 | |||
|---|---|---|---|---|
| 平均 | 最坏情况 | 平均 | 最坏情况 | |
| QMap<Key, T> | O(logn) | O(logn) | O(logn) | O(logn) |
| QMultiMap<Key, T> | O(logn) | O(logn) | O(logn) | O(logn) |
| QHash<键, T> | 摊还时间复杂度 O(1) | O(n) | 摊还复杂度 O(1) | O(n) |
| QSet<Key> | 平均时间复杂度 O(1) | O(n) | 平均时间复杂度 O(1) | O(n) |
当QList 、QHash 和QSet 时,追加元素的性能在摊还意义上为O(logn)。若在插入元素之前,先调用QList::reserve()、QHash::reserve()或QSet::reserve()并传入预期元素个数,则可将该复杂度降至O(1)。下一节将对此主题进行更深入的探讨。
对基本类型和可重定位类型的优化
如果存储的元素是可重定位的,甚至是基本类型,Qt 容器可以使用优化的代码路径。但是,并非在所有情况下都能检测到类型是基本类型还是可重定位类型。 您可以通过使用Q_DECLARE_TYPEINFO 宏并配合Q_PRIMITIVE_TYPE或Q_RELOCATABLE_TYPE标志,将类型声明为基本类型或可重定位类型。有关更多详细信息和使用示例,请参阅Q_DECLARE_TYPEINFO 的文档。
如果您不使用Q_DECLARE_TYPEINFO ,Qt 将使用std::is_trivial_v<T>来识别基本类型,并且需要同时满足std::is_trivially_copyable_v<T>和std::is_trivially_destructible_v<T>才能识别可重定位类型。 尽管性能可能稍逊一筹,但这始终是一个安全的选择。
增长策略
QList<T>、QString 和QByteArray 会将元素连续地存储在内存中;而QHash<Key, T> 则维护一个哈希表,其大小与哈希表中的元素数量成正比。为了避免每次在容器末尾添加元素时都重新分配内存,这些类通常会预先分配比实际所需更多的内存。
请看以下代码,它从另一个QString 构建一个QString :
QString onlyLetters(const QString &in)
{
    QString out;
    for (qsizetype j = 0; j < in.size(); ++j) {
        if (in.at(j).isLetter())
            out += in.at(j);
    }
    return out;
}我们通过每次向字符串out 追加一个字符,动态构建该字符串。 假设我们向QString 字符串追加了15000个字符。那么,当QString 空间耗尽时,会发生以下11次reallocation(总共可能发生15000次):8、24、56、120、248、504、 1016、2040、4088、8184、16376。最终,QString 已分配了 16376 个 Unicode 字符,其中 15000 个已被占用。
上述数值可能看起来有些奇怪,但其中存在一个指导原则。它每次都会将大小翻倍。更准确地说,它是递增到下一个2的幂,再减去16字节。16字节对应8个字符,因为QString 在内部使用UTF-16编码。
QByteArray 采用与QString 相同的算法,但 16 字节对应 16 个字符。
QList<T> 同样使用该算法,但 16 字节对应 16/sizeof(T) 个元素。
QHash<Key, T> 则完全是另一种情况。QHash 的内部哈希表按 2 的幂次增长,每次增长时,项都会被重新分配到一个新的桶中,该桶由qHash(key) %QHash::capacity()(桶的数量) 计算得出。这一说明同样适用于QSet<T> 和QCache<Key, T>。
对于大多数应用程序而言,Qt 提供的默认扩展算法已足够满足需求。若需更多控制权,QList<T>、QHash<KEY, T>、QSet<T>、QString 以及QByteArray 这三组函数可让您检查并指定用于存储项的内存大小:
- capacity() 返回已分配内存所对应的项数(对于QHash 和QSet ,即哈希表中的桶数)。
- reserve(size) 会为size个项目显式预分配内存。
- squeeze() 释放存储这些项目之外多余的内存。
如果您大致知道将在容器中存储多少个项目,可以先调用reserve();当完成容器的填充后,再调用squeeze() 来释放多余的预分配内存。
© 2026 The Qt Company Ltd. Documentation contributions included herein are the copyrights of their respective owners. The documentation provided herein is licensed under the terms of the GNU Free Documentation License version 1.3 as published by the Free Software Foundation. Qt and respective logos are trademarks of The Qt Company Ltd. in Finland and/or other countries worldwide. All other trademarks are property of their respective owners.
